library(tidyverse)
iris2 <- tibble(iris)Lösungen Aufgaben 2
Aufgabe 2.1: EDA - Datensatz iris
Verschaffen Sie sich einen Überblick über die Datentabelle iris aus dem Paket datasets, das immer geladen ist. Der Datensatz ist kein Tibble, sondern ein Data Frame.
Mit
kann der Datensatz in einen Tibble ungewandelt werden. Arbeiten sie nun mit dem Datensatz iris2 und beantworten Sie nun die folgenden Fragen.
- Worum geht es in dem Datensatz?
- Wie viele Merkmale wurden abgefragt und wie viele Beobachtungen gibt es?
- Visualisieren Sie alle metrischen Merkmale einzeln(!) unter Berücksichtigung des Merkmals
Species. Nutzen Sie verschiedene Grafiktypen dazu. Welche Vorteile haben die jeweiligen Grafiken? - Welcher Zusammenhang besteht zwischen der Ausgabe der Funktion
summary(iris2)und den Boxplots?
- Visualisieren Sie den Zusammenhang zwischen
Sepal.LengthundPetal.Lengthunter Berücksichtigung derSpecies. Beschriften Sie die Achsen sinnvoll. - Zeichenen Sie species-abhängige Regressionsgeraden in die vorherige Grafik.
Lösung
library(pacman)
p_load(tidyverse, patchwork)

iris2 <- tibble(iris)
iris2
# A tibble: 150 × 5
Sepal.Length Sepal.Width Petal.Length Petal.Width Species
<dbl> <dbl> <dbl> <dbl> <fct>
1 5.1 3.5 1.4 0.2 setosa
2 4.9 3 1.4 0.2 setosa
3 4.7 3.2 1.3 0.2 setosa
4 4.6 3.1 1.5 0.2 setosa
5 5 3.6 1.4 0.2 setosa
6 5.4 3.9 1.7 0.4 setosa
7 4.6 3.4 1.4 0.3 setosa
8 5 3.4 1.5 0.2 setosa
9 4.4 2.9 1.4 0.2 setosa
10 4.9 3.1 1.5 0.1 setosa
# ℹ 140 more rows- Beim dem Iris Datensatz handelt es sich um Blumen und die Längen / Breiten der Blätter
- Es gibt 150 Beobachtungen und 5 Merkmale.
- Hier ist ein Foto der Iris Blüten.

- Zuerst die Längen:
iris2 |>  ggplot(aes(x = Sepal.Length)) +
         geom_histogram() +
         facet_wrap(~Species)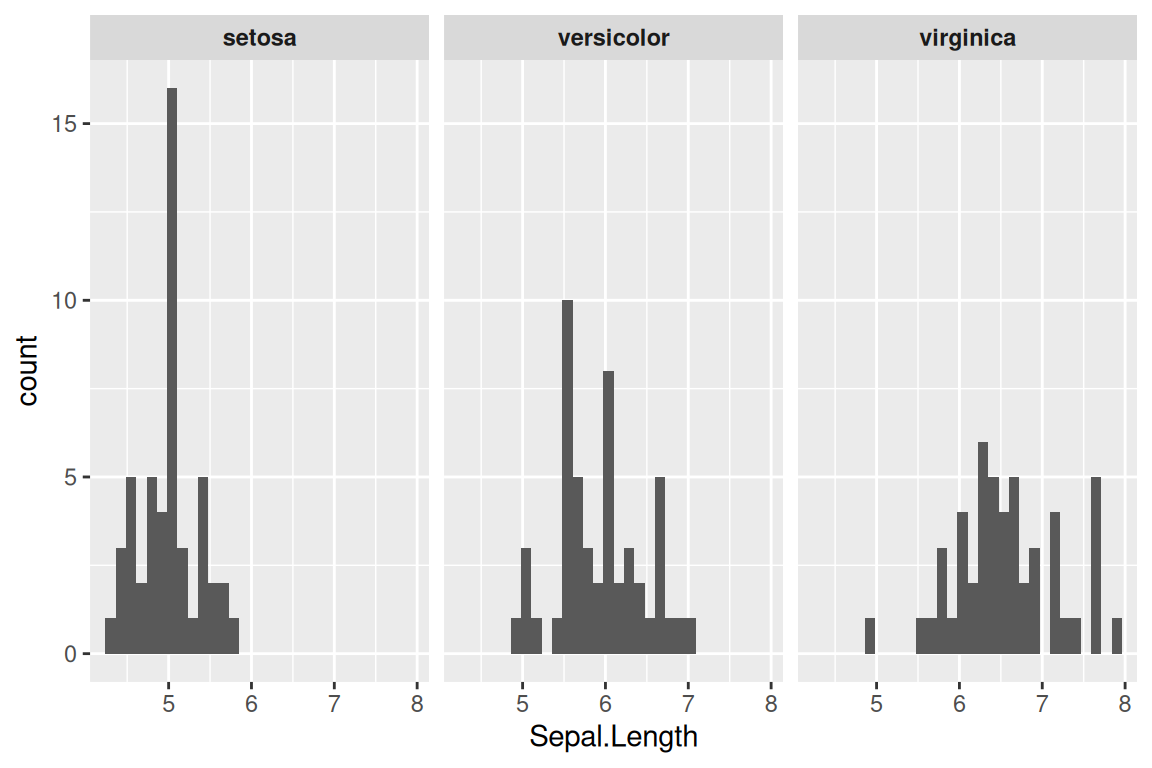
iris2 |>  ggplot(aes(x = Species, y = Sepal.Length)) +
geom_boxplot() 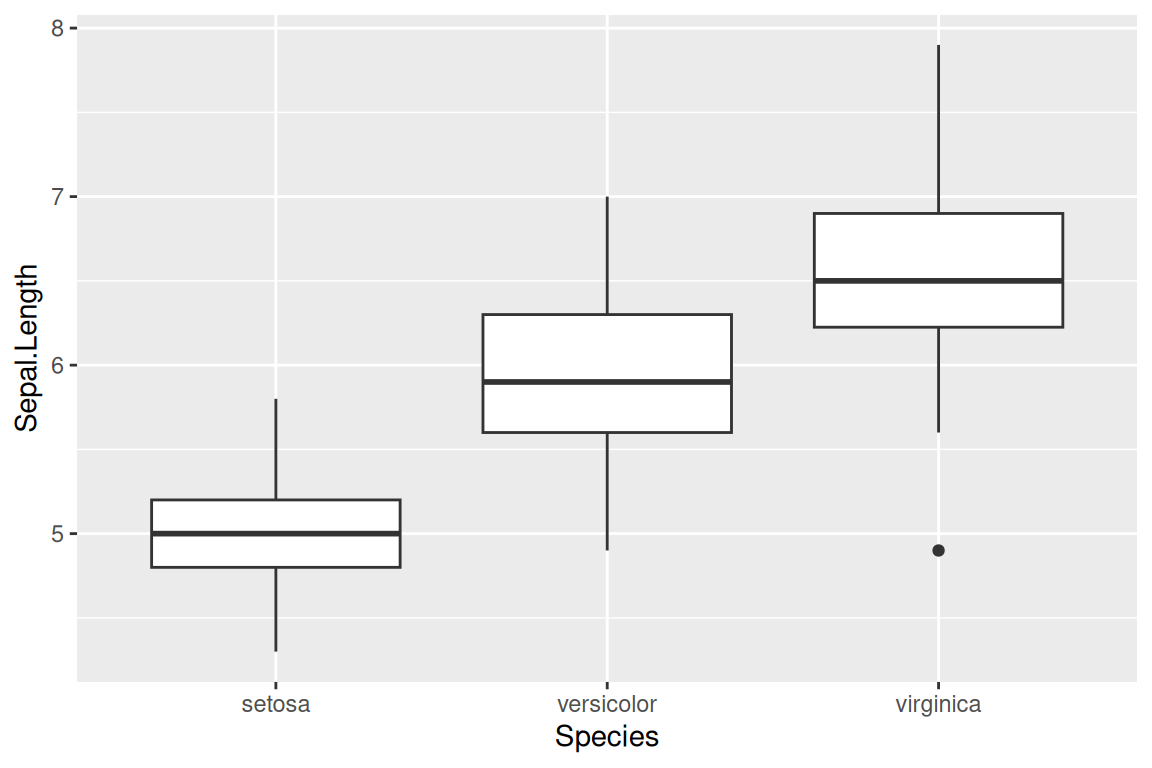
iris2 |>  ggplot(aes(x = Species, y = Sepal.Length)) +
geom_violin() 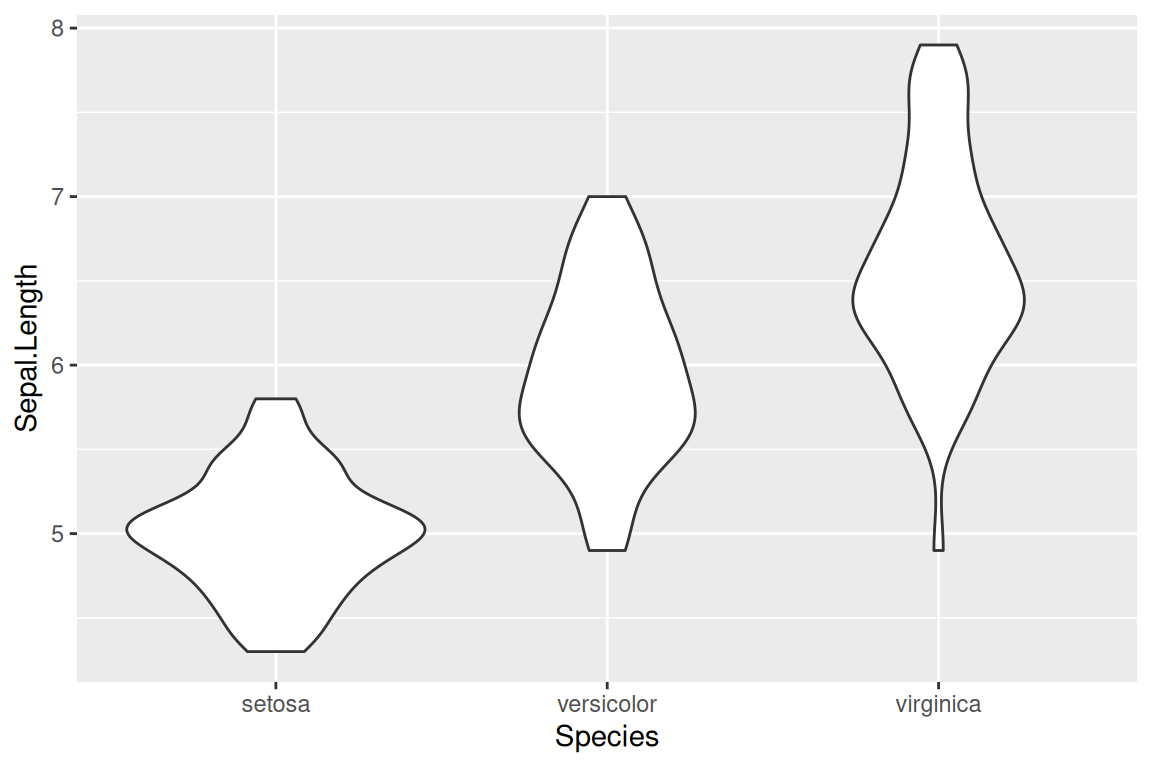
Dann die Breiten:
iris2 |>  ggplot(aes(x = Sepal.Width)) +
         geom_histogram() +
         facet_wrap(~Species)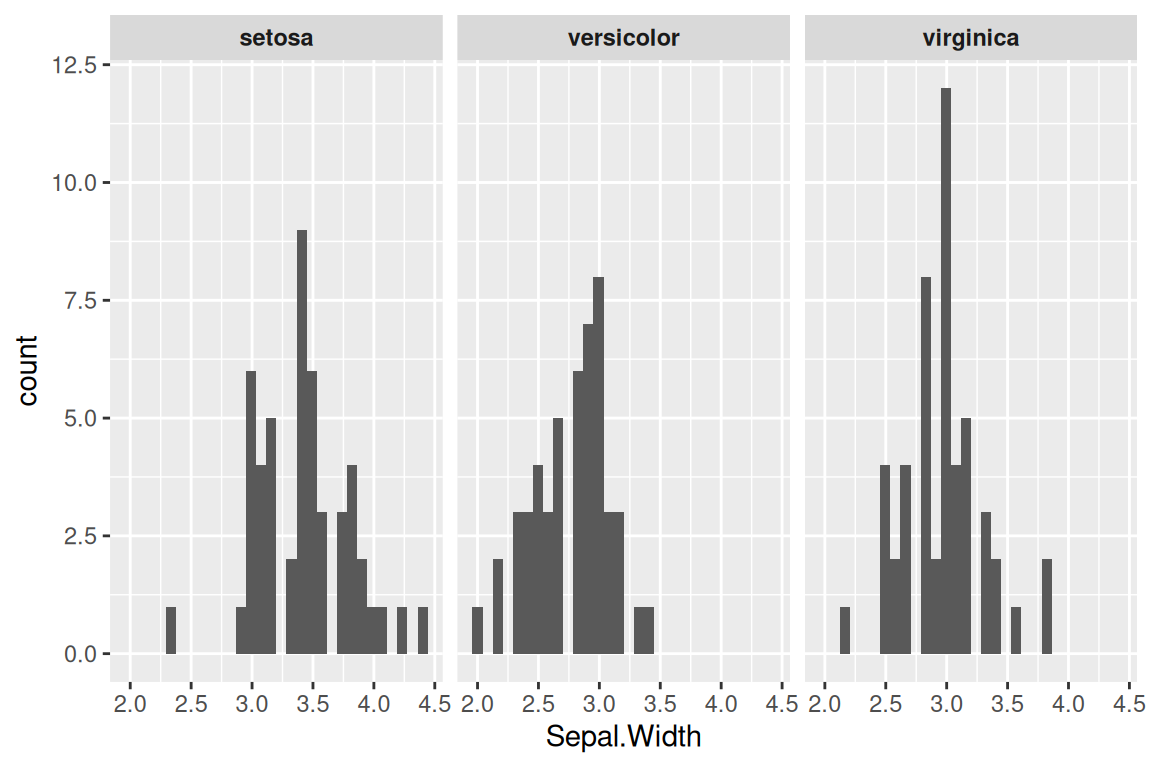
iris2 |>  ggplot(aes(x = Species, y = Sepal.Width)) +
geom_boxplot() 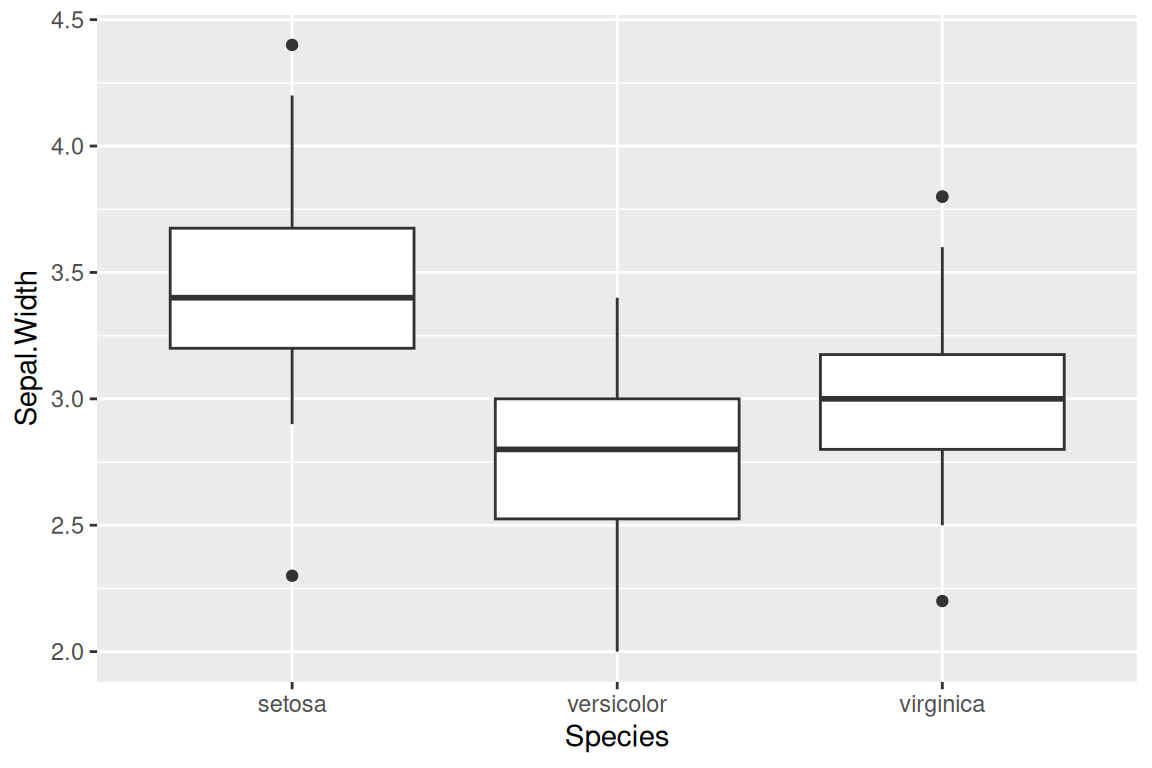
iris2 |>  ggplot(aes(x = Species, y = Sepal.Width)) +
geom_violin() 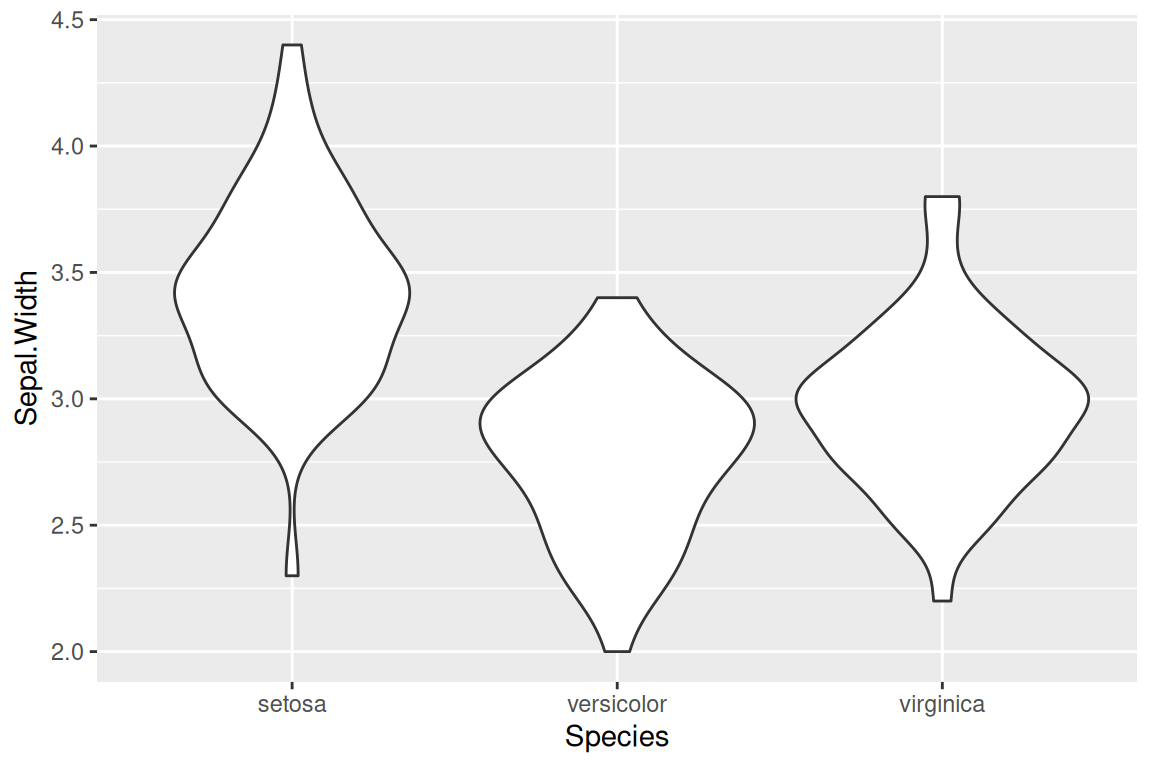
In der Summary Min. :4.300 , 1st Qu.:5.100 , Median :5.800 , Mean :5.843 , 3rd Qu.:6.400 , Max. :7.900 , Min. :2.000 , 1st Qu.:2.800 , Median :3.000 , Mean :3.057 , 3rd Qu.:3.300 , Max. :4.400 , Min. :1.000 , 1st Qu.:1.600 , Median :4.350 , Mean :3.758 , 3rd Qu.:5.100 , Max. :6.900 , Min. :0.100 , 1st Qu.:0.300 , Median :1.300 , Mean :1.199 , 3rd Qu.:1.800 , Max. :2.500 , setosa :50 , versicolor:50 , virginica :50 , NA, NA, NA werden die Quartile angegeben. Diese bestimmen die Box, sowie das Maximum und das Minimium des Boxplots.
iris2 |>  ggplot(aes(x = Sepal.Length, y = Sepal.Width, color = Species)) +
         geom_point() +
         geom_smooth(method = "lm")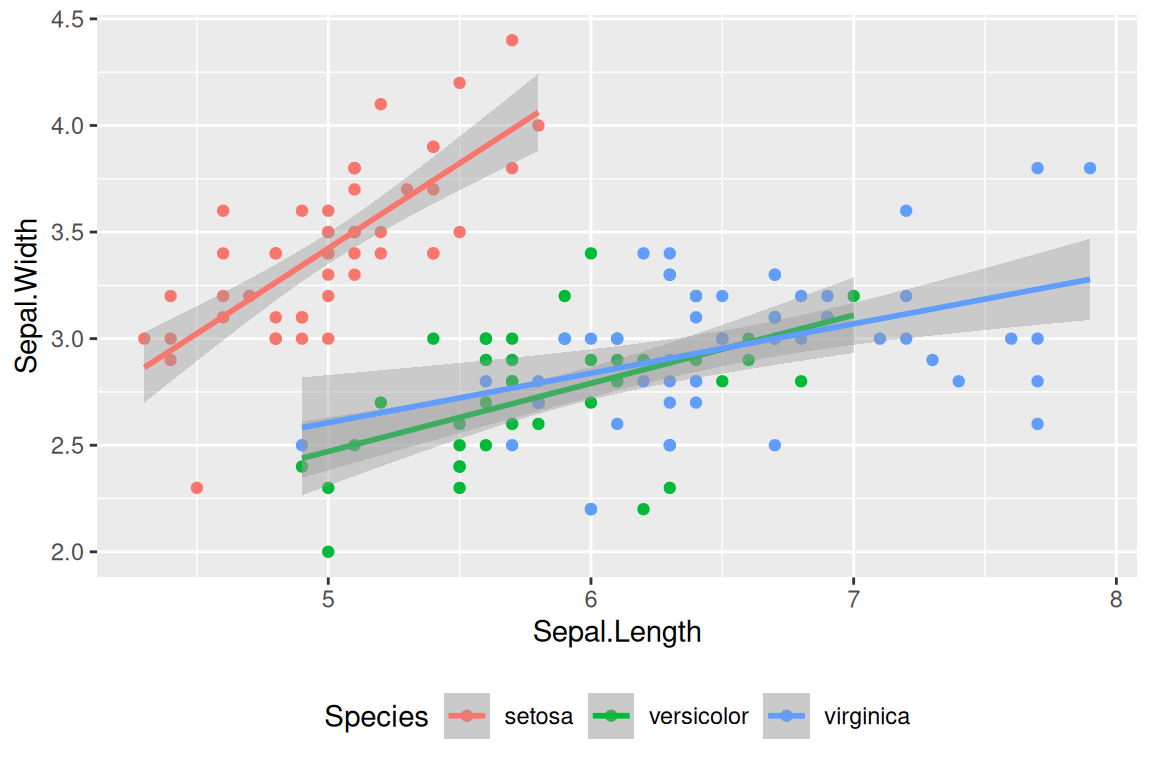
iris2 |>  ggplot(aes(x = Sepal.Length, y = Petal.Length, color = Species)) +
         geom_point() +
         geom_smooth(method = "lm")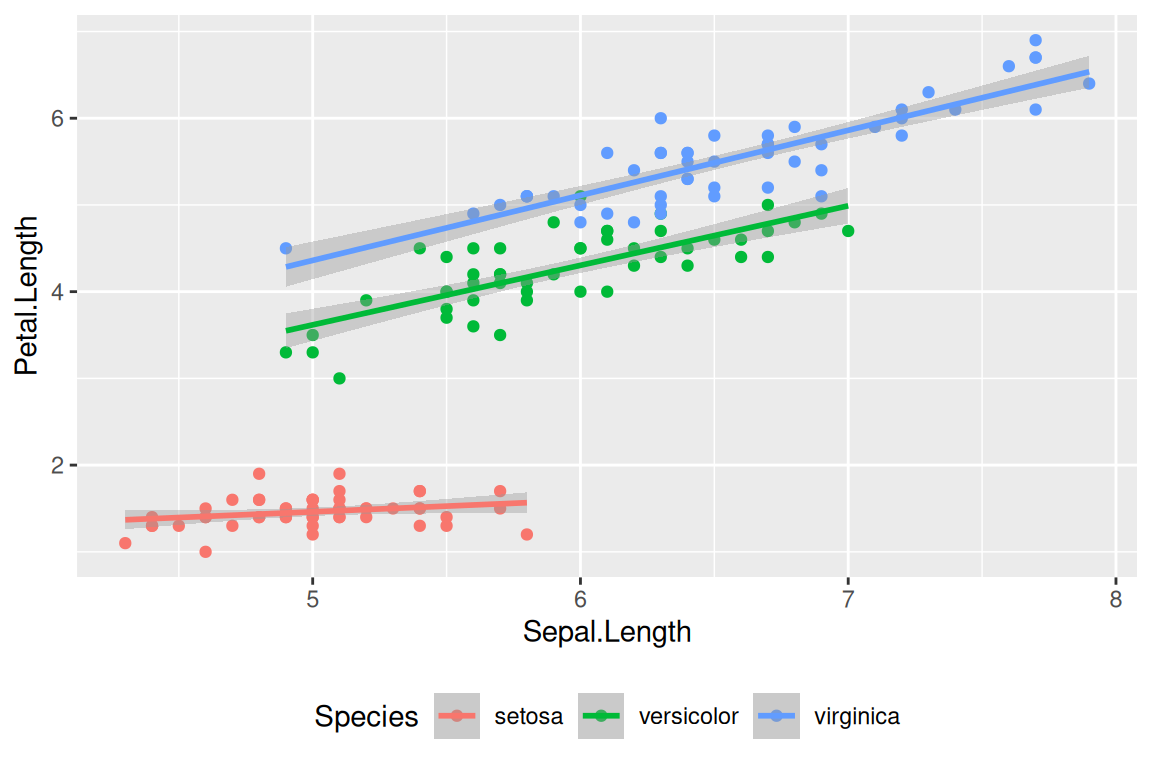
Aufgabe 2.2: EDA - Datensatz diamonds
In den folgenden Teilaufgaben soll die Datentabelle diamonds, die in der ggplot2-Bibliothek enthalten ist, untersucht werden.
- Untersuchen Sie die Verteilung der
x-,y- undz-Variablen indiamonds. Was fällt Ihnen auf? Welche der Variablenx,yundzwürden Sie mit Länge, welche mit Breite und welche mit Tiefe des Diamanten beschreiben? - Untersuchen Sie die Verteilung des Merkmals
price. Entdecken Sie irgendetwas Ungewöhnliches oder Überraschendes? Hinweis: Spielen Sie mit verschiedenen Werte der Intervallbreite (binwidth). - Wie viele Diamanten mit 0.99 Karat gibt es? Und wie viele mit 1,00 Karat? Woher kommt der große Unterschied?
- Untersuchen Sie erneut die Verteilung des Merkmals
price. Sie wollen nun mitcoord_cartesian()oder mitxlim()bzw.ylim()nur einen bestimmten Ausschnitt des Histogramms betrachten. Was ist der Unterschied zwischen den beiden Varianten. Was passiert, wenn Sie das Argumentbinwidthnicht festlegen?
Lösung
# Laden der Pakete:

library(pacman)
p_load(tidyverse, patchwork)
# i)
a1 <- diamonds |> filter(x > 0) |>
ggplot(aes(x = x)) +
geom_histogram()
a2 <- diamonds |> filter(y > 0, y < 20) |>
ggplot(aes(x = y)) +
geom_histogram()
a3 <- diamonds |> filter(z >0, z < 20) |>
ggplot(aes(x = z)) +
geom_histogram()
(a1|a2|a3)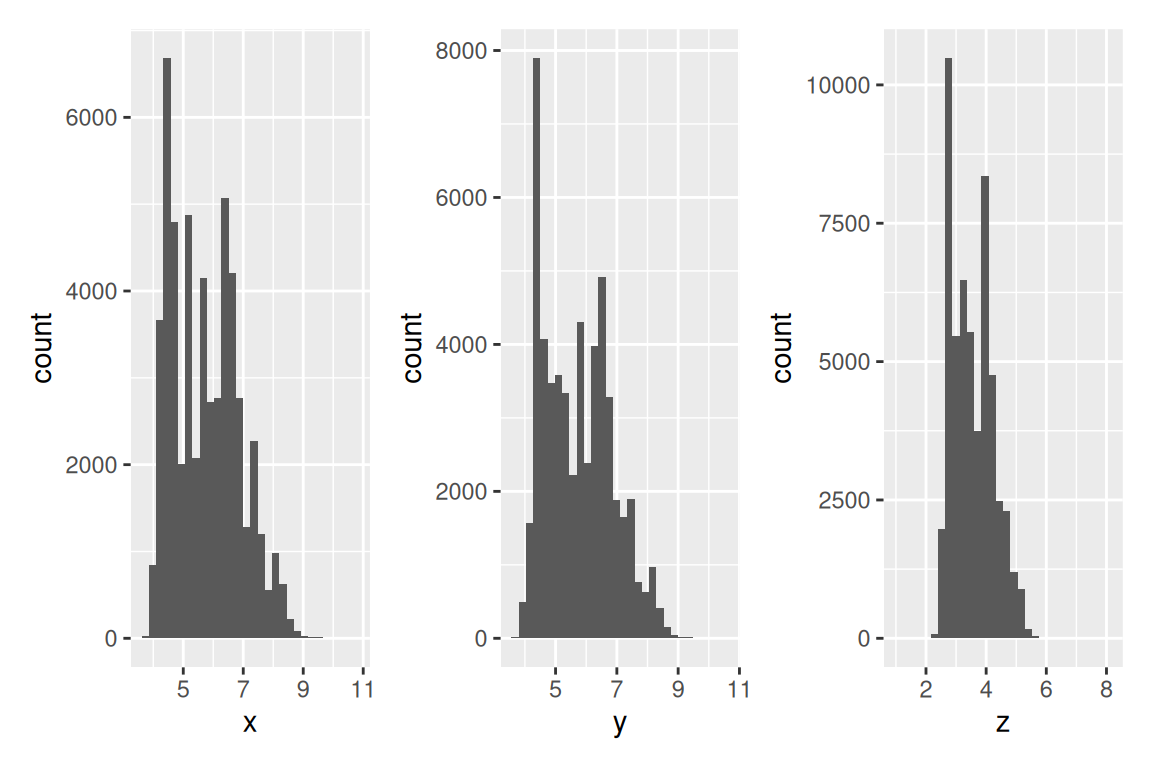
# Verteilung x und y etwa gleich, z ist Verteilung anders, daher Tiefe.

## Vorgriff: wenn man die Graphik mit Facetten machen möchte, macht man folgendes:

diamonds |> pivot_longer(c(x,y,z), names_to = "dimension",
                                   values_to = "values") |>
            filter(between(values, 0.1, 15)) |>
            ggplot(aes(x = values)) +
               geom_histogram() +
               facet_wrap(~dimension)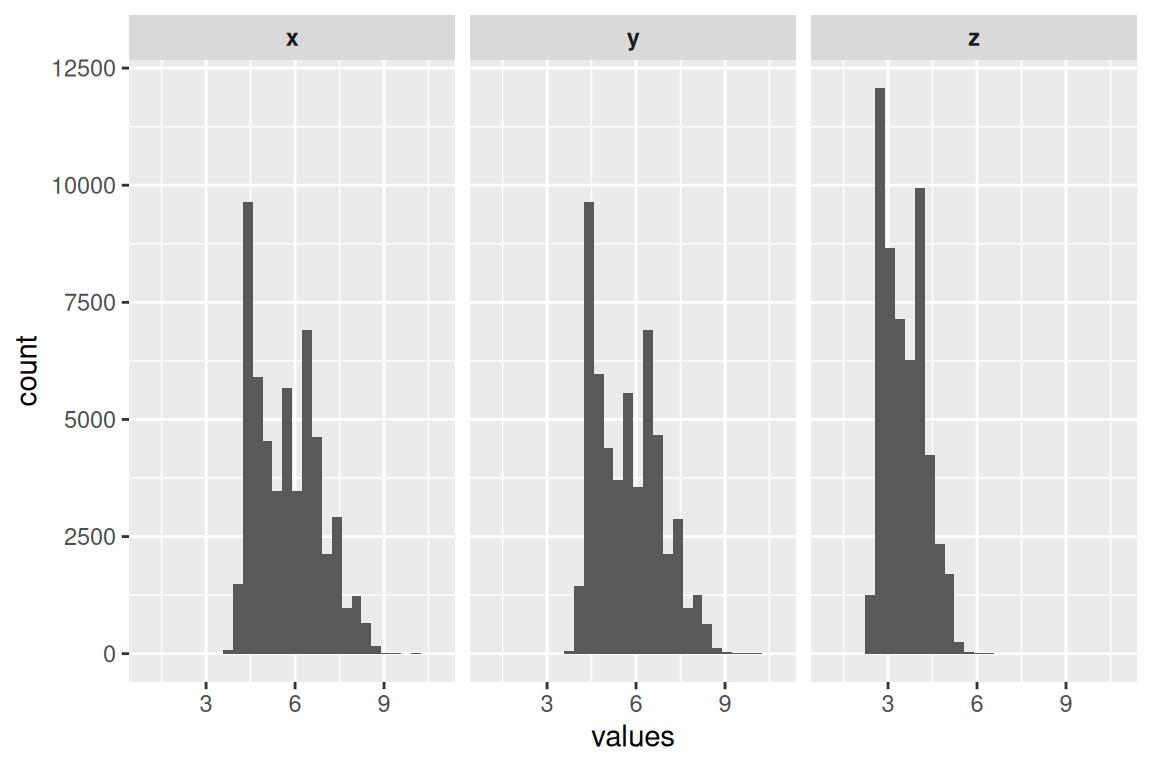
# ii)

diamonds |> ggplot(aes(x = price)) +
                geom_histogram()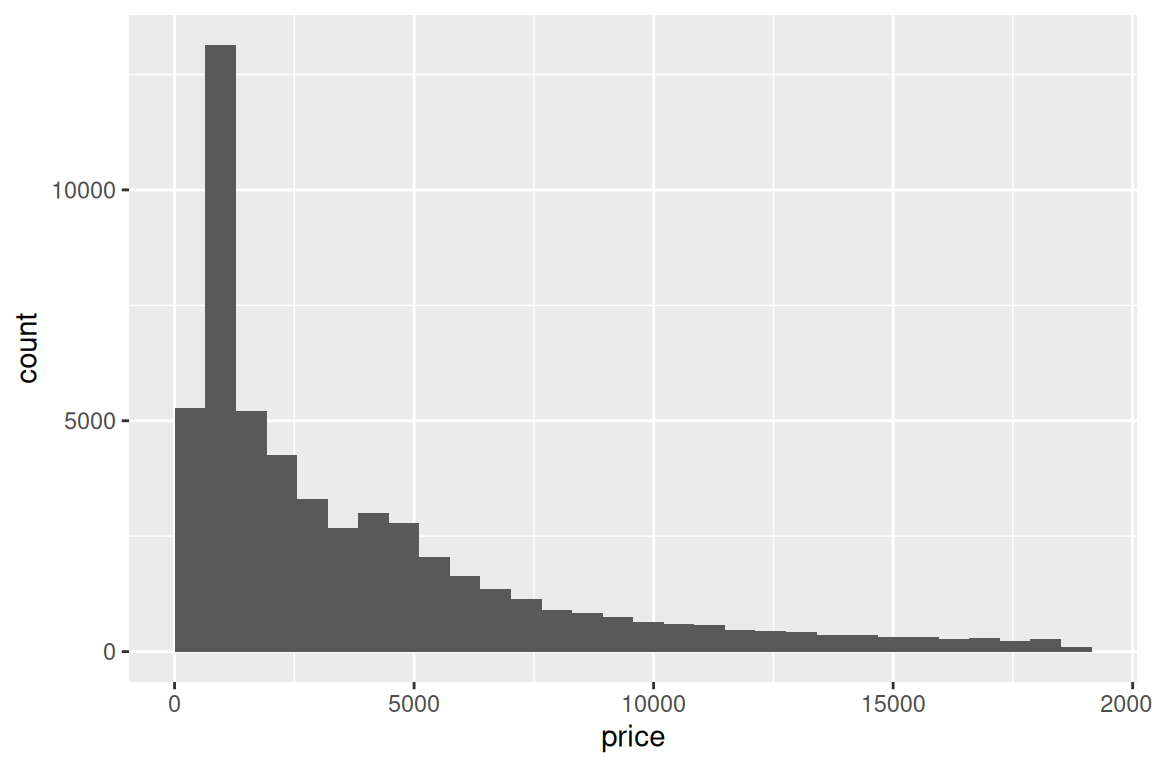
diamonds |> ggplot(aes(x = price)) +
                geom_histogram(binwidth = 100)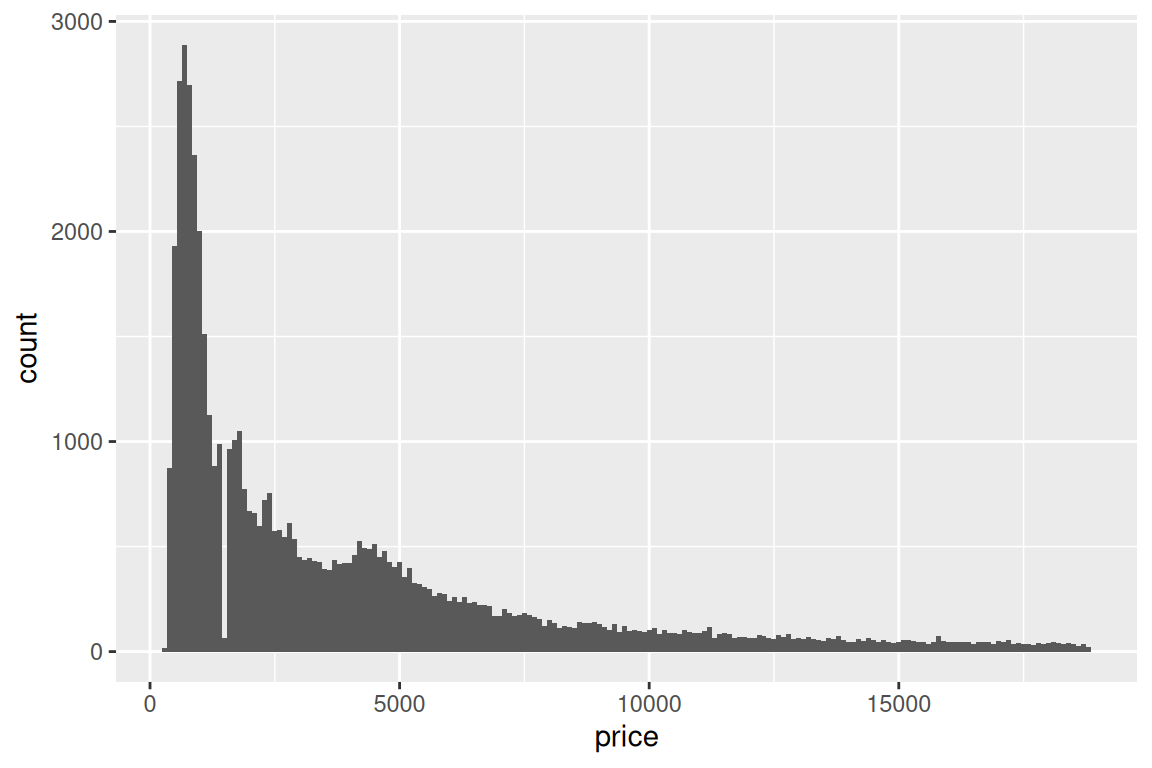
diamonds |> filter(between(price, 1400, 1600)) |>
            ggplot(aes(x = price)) +
                 geom_histogram(binwidth = 5) +
                 coord_cartesian(xlim = c(1400,1600))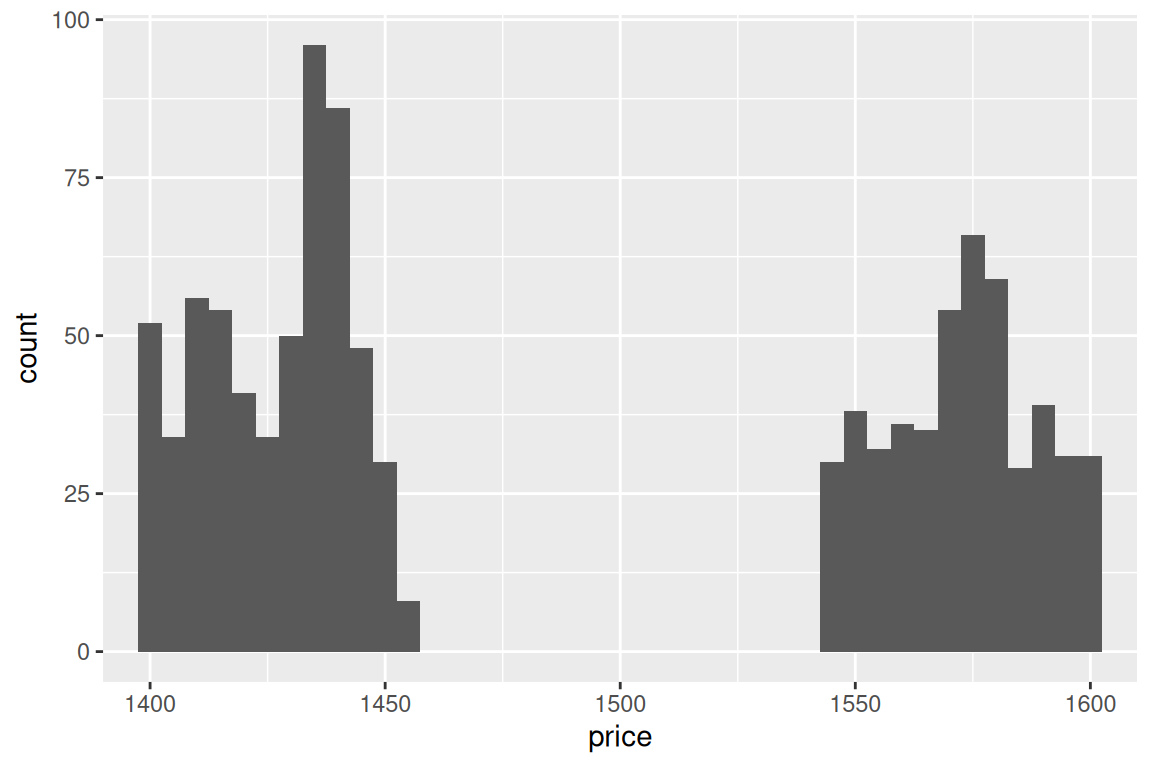
# iii)

diamonds |>  filter(between(carat, 0.95, 1.05)) |>
             count(carat)
# A tibble: 11 × 2
carat n
<dbl> <int>
1 0.95 65
2 0.96 103
3 0.97 59
4 0.98 31
5 0.99 23
6 1 1558
7 1.01 2242
8 1.02 883
9 1.03 523
10 1.04 475
11 1.05 361# für alle:
diamonds |> group_by(carat) |>
summarize(anzahl = n()) # A tibble: 273 × 2
carat anzahl
<dbl> <int>
1 0.2 12
2 0.21 9
3 0.22 5
4 0.23 293
5 0.24 254
6 0.25 212
7 0.26 253
8 0.27 233
9 0.28 198
10 0.29 130
# ℹ 263 more rows# danach kann man filtern oder sich die häufigsten / seltesten Ausprägungen ansehen:
diamonds |> group_by(carat) |>
summarize(anzahl = n()) |>
filter(between(carat, 0.95, 1.05)) # A tibble: 11 × 2
carat anzahl
<dbl> <int>
1 0.95 65
2 0.96 103
3 0.97 59
4 0.98 31
5 0.99 23
6 1 1558
7 1.01 2242
8 1.02 883
9 1.03 523
10 1.04 475
11 1.05 361diamonds |> group_by(carat) |>
summarize(anzahl = n()) |>
slice_max(anzahl, n = 20) # A tibble: 20 × 2
carat anzahl
<dbl> <int>
1 0.3 2604
2 0.31 2249
3 1.01 2242
4 0.7 1981
5 0.32 1840
6 1 1558
7 0.9 1485
8 0.41 1382
9 0.4 1299
10 0.71 1294
11 0.5 1258
12 0.33 1189
13 0.51 1127
14 0.34 910
15 1.02 883
16 0.52 817
17 1.51 807
18 1.5 793
19 0.72 764
20 0.53 709diamonds |> group_by(carat) |>
summarize(anzahl = n()) |>
slice_min(anzahl, n = 20)# A tibble: 21 × 2
carat anzahl
<dbl> <int>
1 2.59 1
2 2.64 1
3 2.65 1
4 2.67 1
5 2.7 1
6 2.71 1
7 2.77 1
8 3.02 1
9 3.05 1
10 3.11 1
# ℹ 11 more rowsGrund warum viel mehr 1.00 als 0.99: Hört sich halt nicht so gut an...
# iv)

d1 <- diamonds |> ggplot(aes(x = price)) +
                  geom_histogram() +
                  xlim(1000,5000)

d2 <- diamonds |> ggplot(aes(x = price)) +
                  geom_histogram() +
                  xlim(1000,1200)

(d1|d2)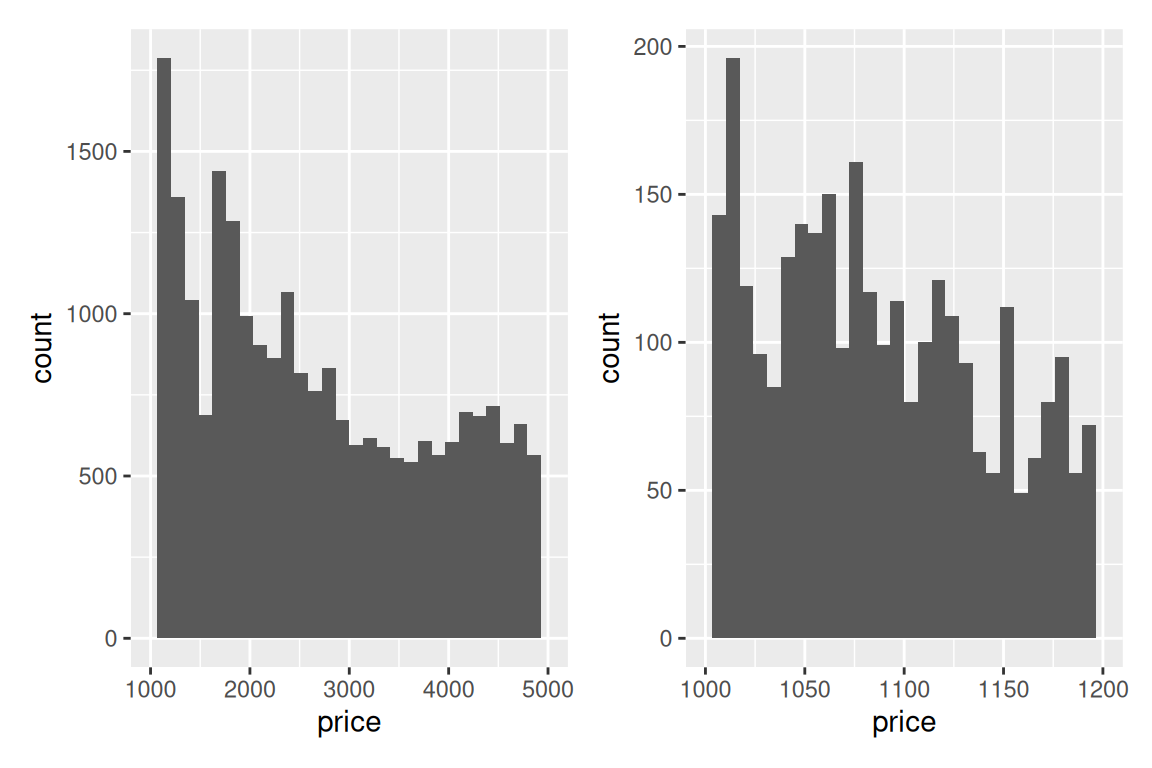
# hier ändert sich die Anzahl der Bins nicht!

d3 <- diamonds |> ggplot(aes(x = price)) +
                  geom_histogram() +
                  coord_cartesian(xlim=c(0, 10000))

d4 <- diamonds |> ggplot(aes(x = price)) +
                  geom_histogram() +
                  coord_cartesian(xlim=c(1000, 3000))

(d3|d4)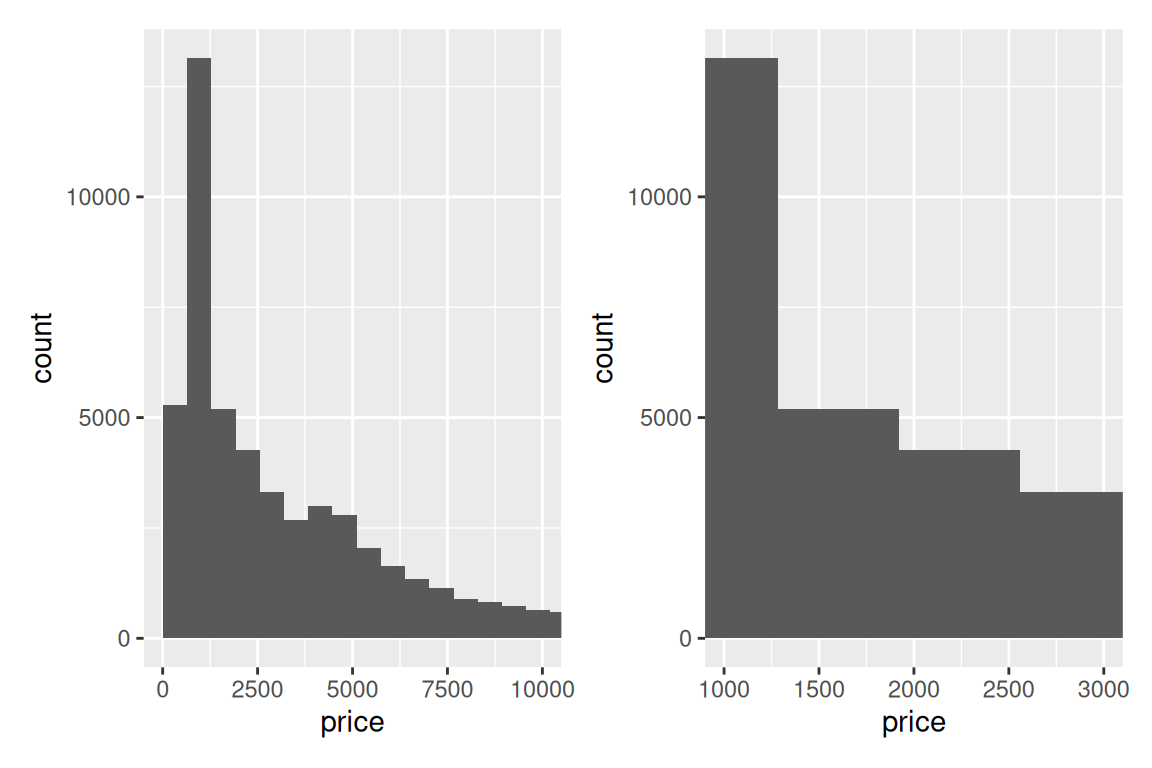
# hier zoomt man wirklich in das Bild hinein.Aufgabe 2.3: EDA - Datensatz UCBAdmissions
In den folgenden Teilaufgaben untersuchen Sie den Zusammenhang zwischen der Zulassung zum Studium an einer Universität und dem Geschlecht. Wir verwenden hierfür die Datentabelle UCBAdmissions (aus dem Paket datasets), die die Zulassungszahlen der University of Berkley je Fakultät enthält. In der Aufgabe wird ein scheinbarer Skandal dadurch erklärt, dass man ein zusätzliches Merkmal berücksichtigt.
Bemerkung: Allgemein wird das in der Aufgabe beobachtete Phänomen als Simpson-Paradoxon bezeichnet. Dabei scheint es, dass die Bewertung verschiedener Gruppen (hier: Fakultäten) unterschiedlich ausfällt, je nachdem ob man die Ergebnisse der Gruppen einzeln oder kombiniert betrachtet.
- Verschaffen Sie sich durch
UCBAdmissions(was der Ausführung des Befehlsprint(UCBAdmissions)entspricht) bzw. mitftable(UCBAdmissions)einen ersten Überblick über die Daten. UCBAdmissionsist ein Array und kann mitas_tibblein eine Datentabelle umgewndelt werden, die für die kommenden Analyse in eine neue Variable gespeichert werden muss.- Benutzen Sie die geometrische Funktion
geom_mosaic()aus dem Paketggmosaic, um die eindimensionalen Verteilungen der drei MerkmaleAdmit,GenderundDeptdarzustellen. Beachten Sie, dass die Einträge der Datentabelle bereits aggregierte Anzahlen enthalten und nutzen Sie die Aestheticweight. - Zeichnen Sie einen Mosaikplot für die gemeinsame Verteilung von Admit und Gender. Setzen Sie dazu die Aesthtic
xaufproduct(Gender, Admit)bzw.product(Admit, Gender). Welche Variante sollten Sie wählen, wenn Sie herausfinden wollen, ob die Zulassung vom Geschlecht abhängt? Hinweis: Es hat sich bewährt, die abhängige bzw. „wichtigste“ Variable der Aestheticfillzuzuordnen. Welches Merkmal ist hier das Wichtigste? - Verwenden Sie Facetten, um für jede Fakultät einen eigenen Mosaikplot zu zeichnen.
- Wie können die Ergebnisse aus den beiden vorangegangenen Teilaufgaben erklärt werden?
- Zeichnen Sie einen Mosaikplot für alle drei Merkmale. Wählen Sie die Reihenfolge in
productso, dass die Unabhängigkeit von Geschlecht und Zulassung besonders gut zu sehen ist.
Lösung
# Laden der Pakete:

library(pacman)
p_load(tidyverse)
# i)
UCBAdmissions, , Dept = A
Gender
Admit Male Female
Admitted 512 89
Rejected 313 19
, , Dept = B
Gender
Admit Male Female
Admitted 353 17
Rejected 207 8
, , Dept = C
Gender
Admit Male Female
Admitted 120 202
Rejected 205 391
, , Dept = D
Gender
Admit Male Female
Admitted 138 131
Rejected 279 244
, , Dept = E
Gender
Admit Male Female
Admitted 53 94
Rejected 138 299
, , Dept = F
Gender
Admit Male Female
Admitted 22 24
Rejected 351 317ftable(UCBAdmissions) # flat table Dept A B C D E F
Admit Gender
Admitted Male 512 353 120 138 53 22
Female 89 17 202 131 94 24
Rejected Male 313 207 205 279 138 351
Female 19 8 391 244 299 317# ii)
(ucb <- as_tibble(UCBAdmissions))# A tibble: 24 × 4
Admit Gender Dept n
<chr> <chr> <chr> <dbl>
1 Admitted Male A 512
2 Rejected Male A 313
3 Admitted Female A 89
4 Rejected Female A 19
5 Admitted Male B 353
6 Rejected Male B 207
7 Admitted Female B 17
8 Rejected Female B 8
9 Admitted Male C 120
10 Rejected Male C 205
# ℹ 14 more rows# iii)
p_load(ggmosaic, patchwork)
pc1 <- ucb |> ggplot() +
geom_mosaic(aes(x=product(Admit), weight=n))
pc2 <- ucb |> ggplot() +
geom_mosaic(aes(x=product(Gender), weight=n))
pc3 <- ucb |> ggplot() +
geom_mosaic(aes(x=product(Dept), weight=n))
(pc1|pc2|pc3)
# Würde man so eher nicht machen, statt dessen:

pd1 <- ucb |> ggplot() +
       geom_bar(aes(x=Admit, weight=n), alpha = 0.6) +
       labs(y = "Anzahl")

pd2 <- ucb |> ggplot() +
       geom_bar(aes(x=Gender, weight=n), alpha = 0.6)+
       labs(y = "Anzahl")

pd3 <- ucb |> ggplot() +
       geom_bar(aes(x=Dept, weight=n), alpha = 0.6)+
       labs(y = "Anzahl")

(pd1|pd2|pd3)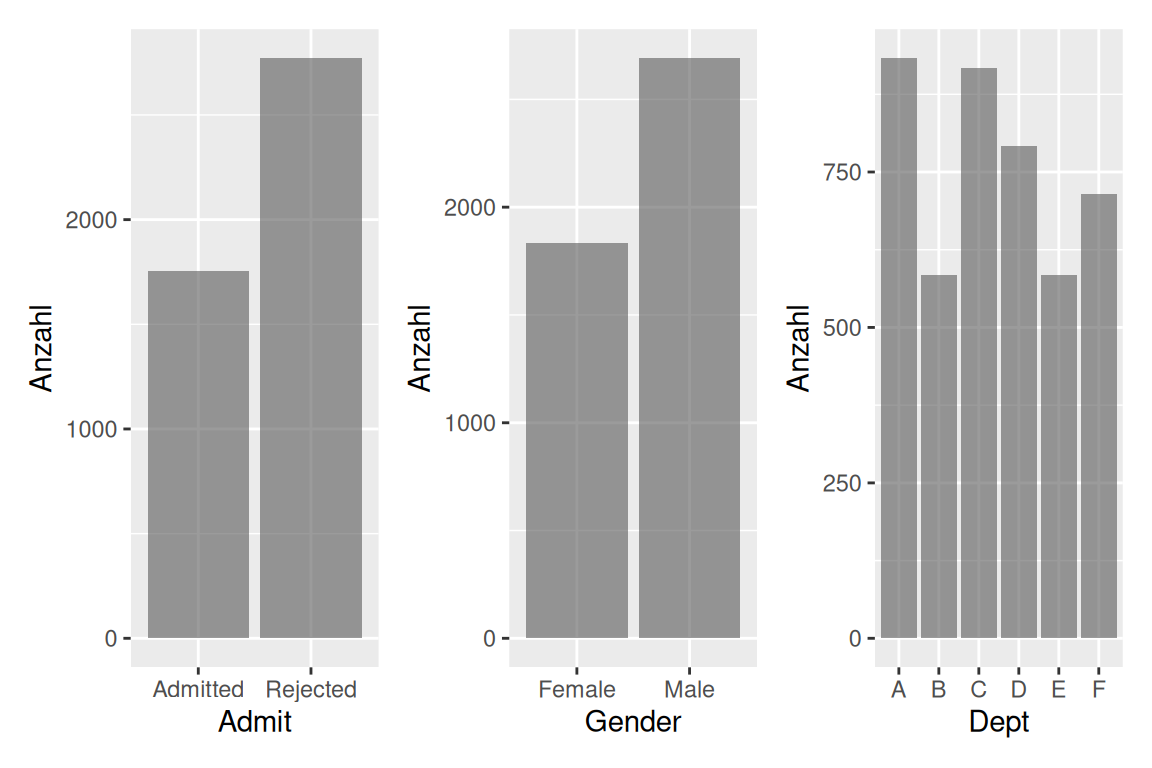
# iv)
ucb |> ggplot() +
       geom_mosaic(aes(x=product(Gender, Admit),
                   weight= n,
                   fill=Admit)) +
       scale_fill_manual(values = hcl(c(130,8)))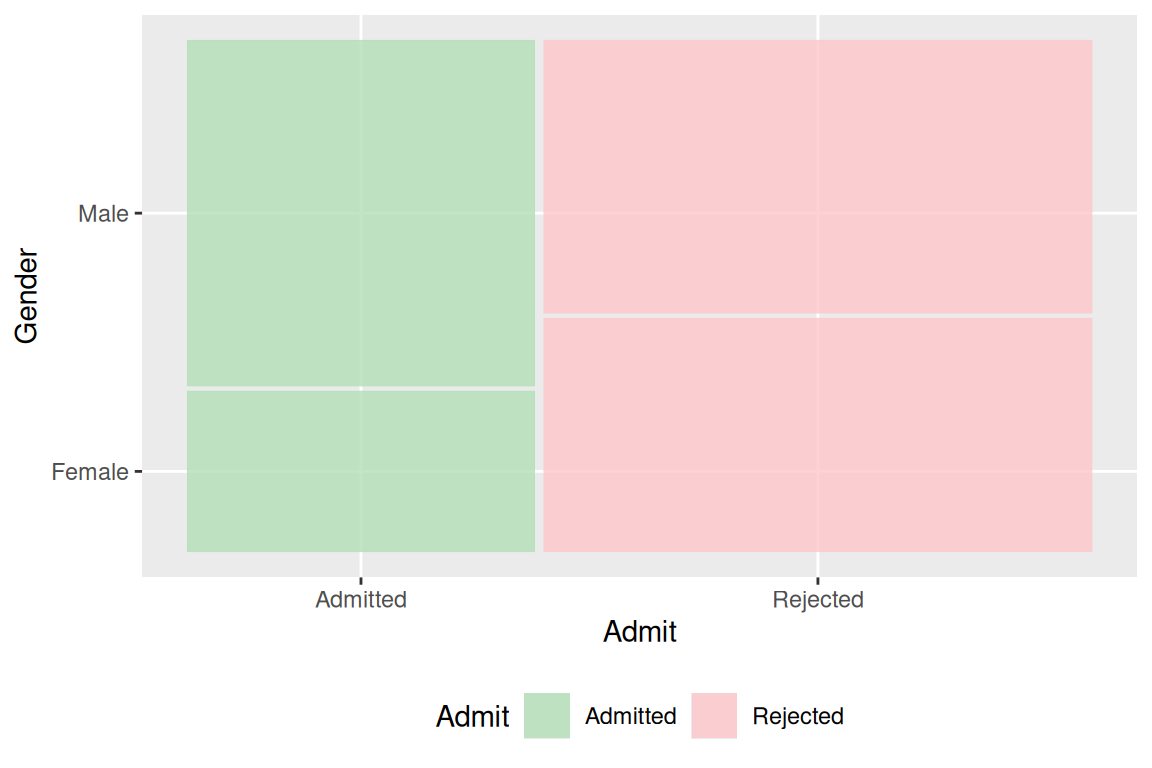
ucb |> ggplot() +
       geom_mosaic(aes(x=product(Admit, Gender),
                   weight= n,
                   fill=Admit)) +
       scale_fill_manual(values = hcl(c(130,8)))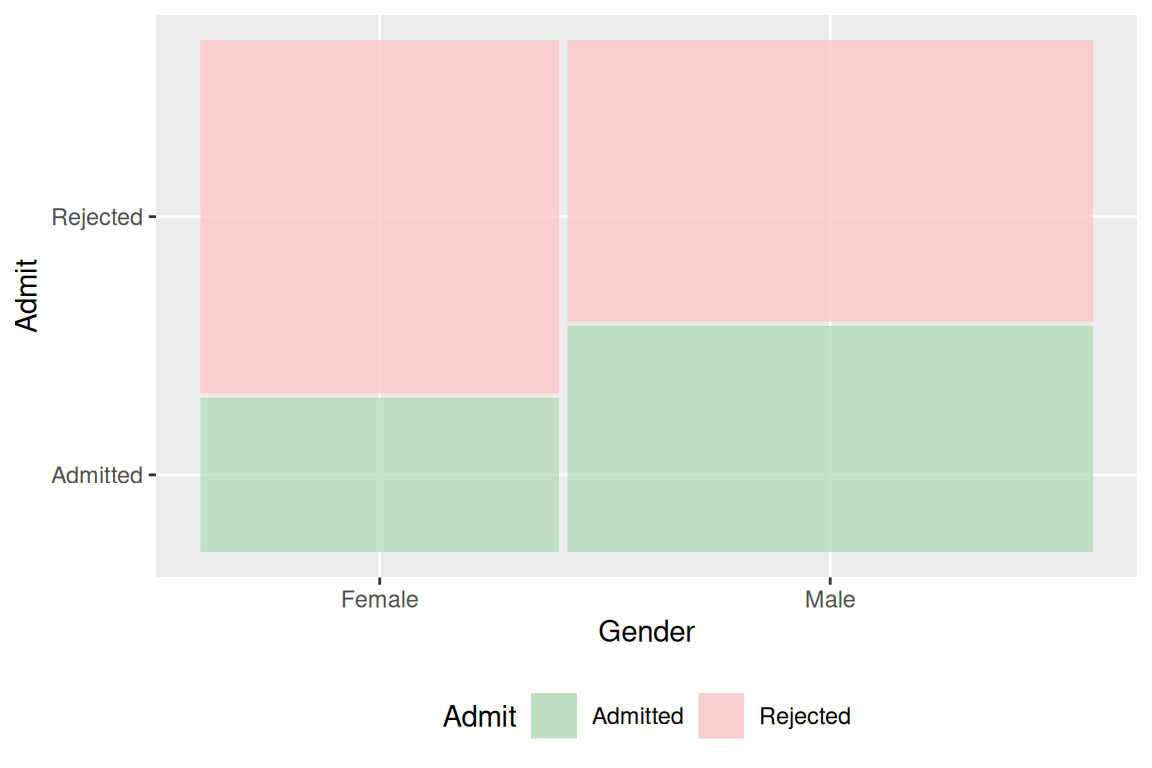
Die zweite Graphik ist besser geeignet: man sieht, dass der Anteil der angenommenen Frauen kleiner ist als der der Männer.
# v) und vi)
ucb |> ggplot() +
       geom_mosaic(aes(x=product(Admit, Gender),
                   weight= n,
                   fill= Admit),
                   color="black") +
          scale_fill_manual(values=hcl(c(120,10))) +
          facet_wrap(~Dept)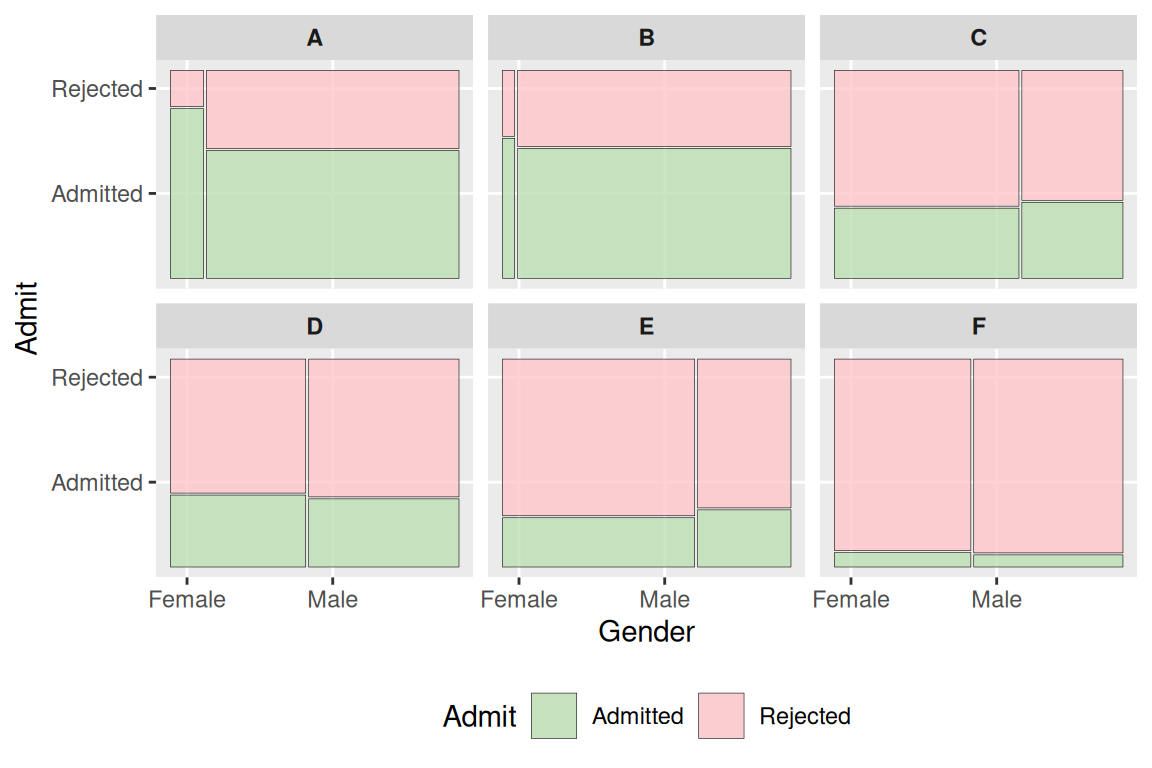
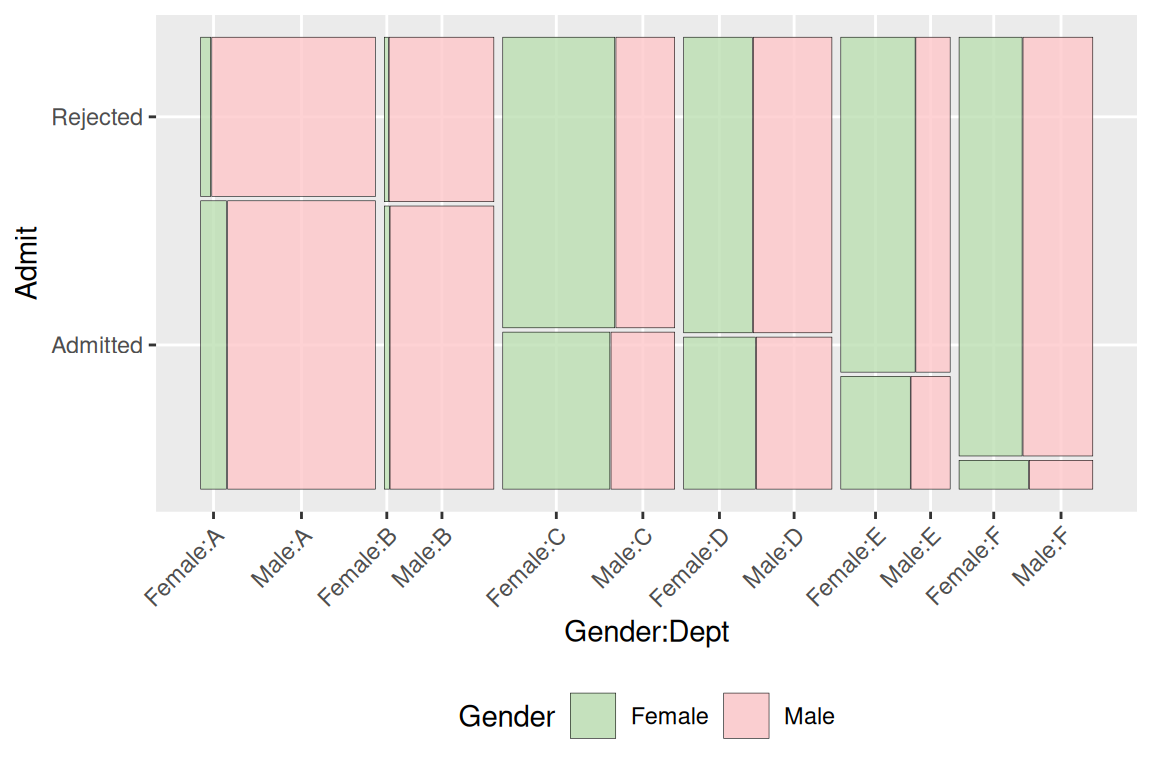
Innerhalb jeder Fakultät ist die Zulassungsquote für Frauen mindestens so hoch wie für Männer. Die Tatsache, dass insgesamt die Zulassungsquote für Frauen niedriger ist als für Männer, liegt daran, dass der Anteil der männlichen Bewerber in Fakultäten mit hoher Zulassungsquote (A und B) wesentlich höher ist als in den Fakultäten mit niedriger Zulassungsquote.
# vii)
ucb |> ggplot() +
       geom_mosaic(aes(x=product(Gender, Admit, Dept),
                   weight=n,
                   fill= Gender),
                   offset=0.01,
                   color="black") +
          scale_fill_manual(values=hcl(c(120,10))) +
          theme(axis.text.x=element_text(angle=45, hjust=1))