c("Auto", TRUE, 1)
c(5, 2, 1, TRUE, FALSE)
rep(c(4,5,6), c(1,2,3))
rep(1:4, each = 3)
1 + 1:2 + 1:4 + 1:8Lösungen Aufgaben 3
Aufgabe 3.1: Grundlagen R
Geben Sie eine möglichst einfache Funktion / Operation an mit der Sie die folgenden Vektoren erstellen können.
- Eine Zahlenfolge von 100 bis 250 in 3er Schritten.
- 30 mal die 5 und danach 20 mal eine 7.
- 17 äquidistante Zahlen zwischen 10 und 15.
- Die Zahlenfolge (4, 7, 12) sechs mal hintereinander.
- Die Zahlen 4, 7 und 12 jeweils sechs mal hintereinander.
Erklären Sie die Ausgaben der folgenden Zeilen. Überlegen Sie sich vor dem Ausprobieren wie das Ergebnis aussehen könnte.
Lösung
seq(100,250,3) [1] 100 103 106 109 112 115 118 121 124 127 130 133 136 139 142 145 148 151 154
[20] 157 160 163 166 169 172 175 178 181 184 187 190 193 196 199 202 205 208 211
[39] 214 217 220 223 226 229 232 235 238 241 244 247 250rep(c(5,7), c(30, 20)) # oder c(rep(5, 30), rep(7, 20)) [1] 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 5 7 7 7 7 7 7 7 7
[39] 7 7 7 7 7 7 7 7 7 7 7 7seq(10, 15, length.out = 17) [1] 10.0000 10.3125 10.6250 10.9375 11.2500 11.5625 11.8750 12.1875 12.5000
[10] 12.8125 13.1250 13.4375 13.7500 14.0625 14.3750 14.6875 15.0000rep(c(4, 7, 12), 6) [1] 4 7 12 4 7 12 4 7 12 4 7 12 4 7 12 4 7 12rep(c(4, 7, 12), each = 6) [1] 4 4 4 4 4 4 7 7 7 7 7 7 12 12 12 12 12 12- Ausgabe siehe oben!
c("Auto", TRUE, 1)[1] "Auto" "TRUE" "1" c(5, 2, 1, TRUE, FALSE)[1] 5 2 1 1 0rep(c(4,5,6), c(1,2,3))[1] 4 5 5 6 6 6rep(1:4, each = 3) [1] 1 1 1 2 2 2 3 3 3 4 4 41 + 1:2 + 1:4 + 1:8[1] 4 7 8 11 8 11 12 15Erklärung zu den ersten beiden Ausgaben: Die Funktion c() ‘zwingt’ (engl.: coerce) alle Datentypen in einen Vektor. Der resultierende Vektor ist von Typ mit der höchsten Komplexität. Die einfachste Struktur sind logische Vektoren, dann ganze Zahlen, dann Fließkommazahlen und die komplexeste Struktur sind die Zeichenketten.
Im zweiten Beispiel werden die Wahrheitswerte zu Zahlen, wobei TRUE einer 1 entspricht und FALSE einer 0, was in manchen Situation ein sehr praktisches Verhalten ist.
Aufgabe 3.2: EDA - Zweiter Teil
Betrachten Sie erneut die Datentabelle diamonds.
Welches Merkmal in der Datentabelle
diamondsist am besten dazu geeignet, den Preis eines Diamanten vorherzusagen? Wie ist diese Variable mit dem Schliff (cut) korreliert? Weshalb lässt sich aus der Kombination dieser beiden Beziehungen ableiten, dass Diamanten mit schlechterem Schliff teurer sind?Hinweis: Um einen ersten Überblick über die Zusammenhänge der Merkmale in der Datentabelle zu erhalten, empfehle ich Ihnen die Funktion
ggpairs()aus der BibliothekGGally. Da in derdiamonds-Datentabelle über 50 000 Diamanten erfasst sind, empfehle ich Ihnen außerdem vor Ausführung des Befehlsggpairs()je nach Leistungsfähigkeit Ihres Rechners eine Stichprobe von 500, 1000 oder 5000 Diamanten zu ziehen. Zum Beispiel:library(pacman) p_load(tidyverse, GGally) set.seed(101) # damit man jedes Mal die gleiche Stichprobe erhält, die Zahl ist egal! diamonds500 <- diamonds |> slice_sample(n = 500) ggpairs(diamonds500) # dauert nur wenige SekundenStellen Sie die Verteilung des Merkmals Preis in Abhängigkeit des Schnitts
mit dem geometrischen Objekt
geom_violin(),mit in Facetten gegliederten Histogrammen und
mit einem verschieden farbigen geometrischen Objekt
geom_freqpoly()dar.
Was sind die Vor- und Nachteile jeder Methode?
Lösung
# Laden der Pakete
library(pacman)
p_load(tidyverse,
       GGally,     # Datenübersicht
       patchwork)  # Plots arrangieren
# i)
d1 <- diamonds |> slice_sample(n = 5000)
ggpairs(d1)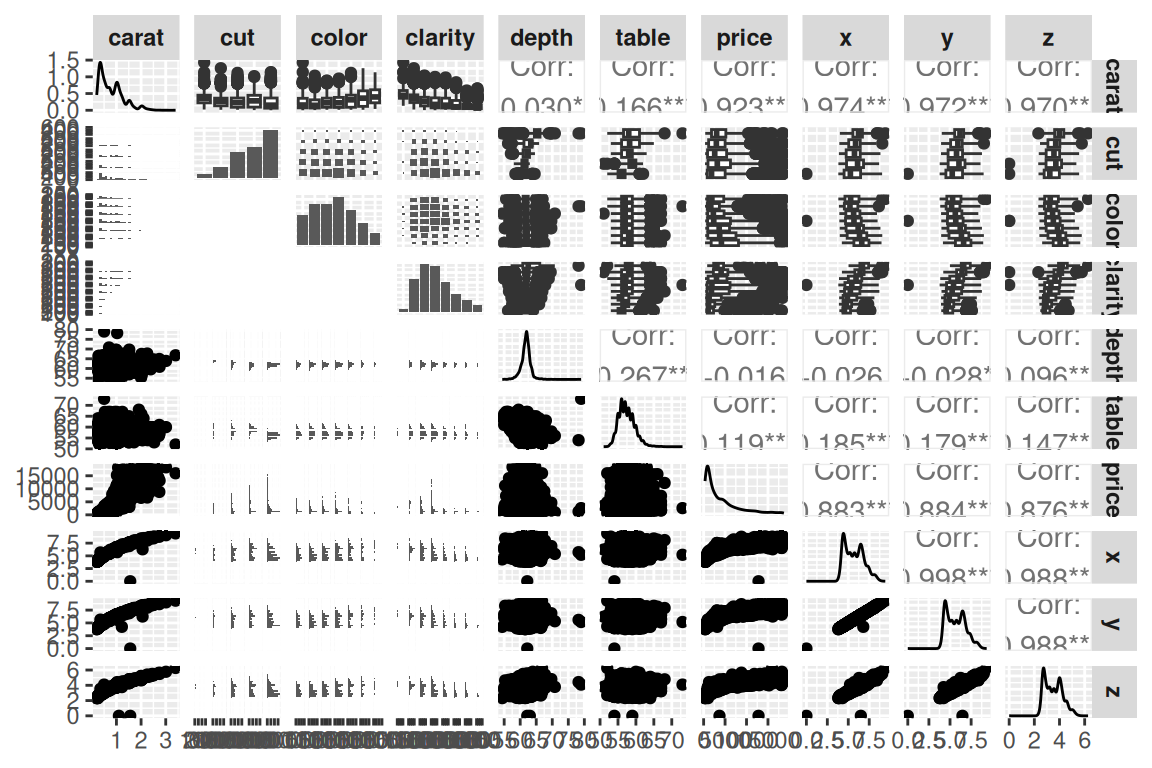
Höchste Korrelation (über alle!) : price / carat \(0.922\), daher ist die beste Vorhersage carat.
diamonds |> ggplot() +
    geom_boxplot(aes(x = cut, y = carat))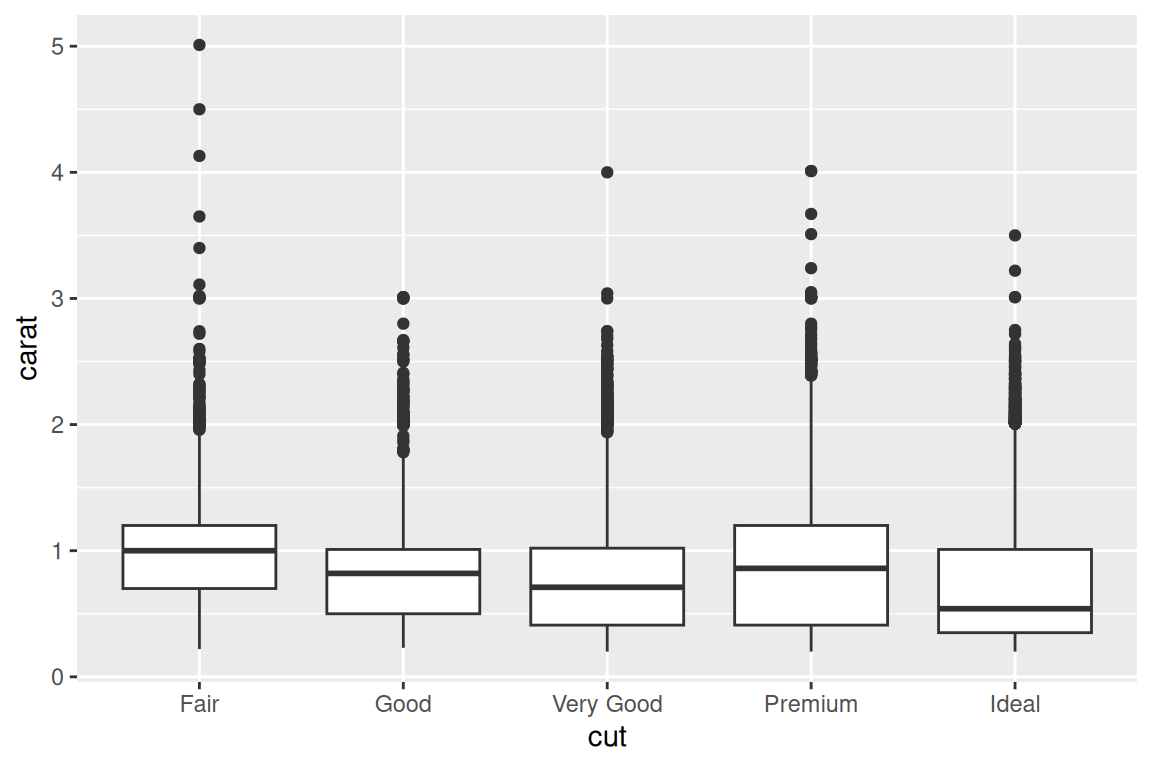
Man erkennt, dass die mittleren Karatwerte um so höher sind, je schlechter der Schliff ist. Wegen dieser Korrelation sind die Diamanten schlechten Schliffs teurer.
# ii)

p1 <- diamonds |> ggplot() +
                  geom_violin(aes(x=cut, y=price))
p2 <- diamonds |> ggplot() +
                  geom_histogram(aes(x=price)) +
                  facet_wrap(~cut,nrow=1) +
                  theme(axis.text.x=element_text(angle=45, hjust=1, size = 8))
p3 <- diamonds |> ggplot() +
                  geom_freqpoly(aes(x=price, color=cut))

(p1/p2/p3)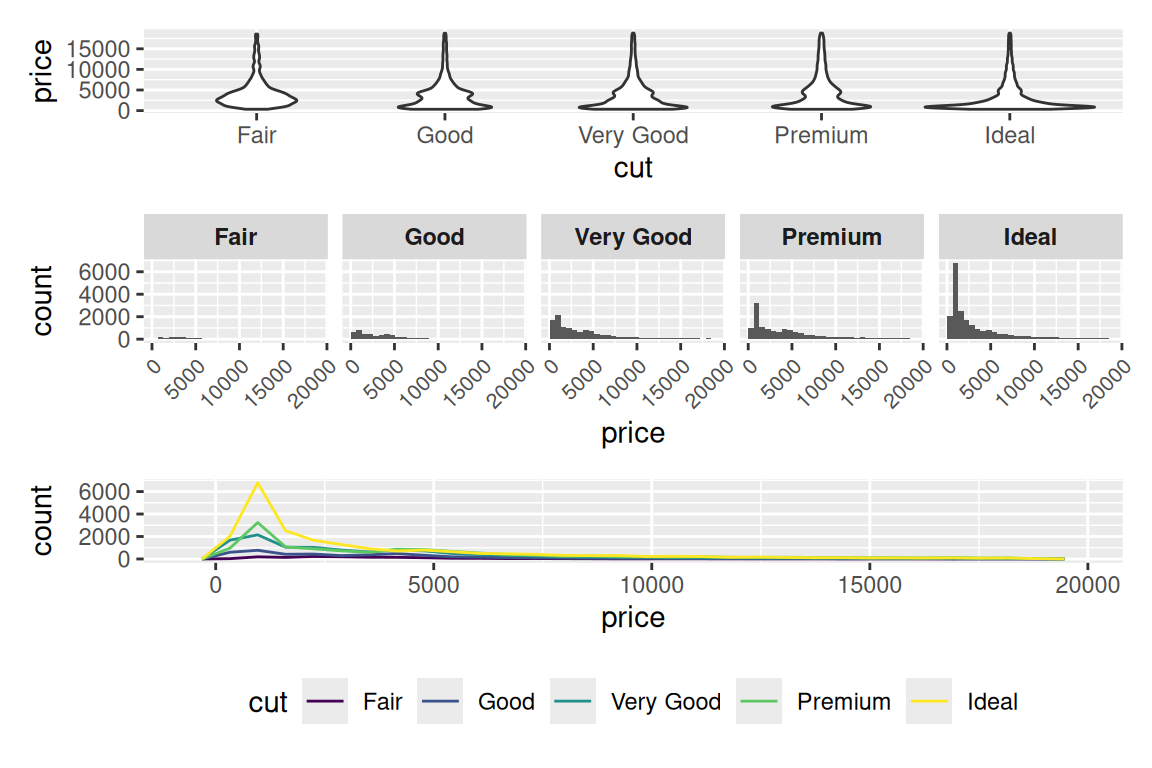
Im Violinenplot und in den gruppierten Boxplots kann man die Verteilung der Preise zwischen den Schnitten sehr gut vergleichen.
Im den gruppierten Histogrammen und auch im Frequenzplot sieht man sehr gut, dass die Anzahl der Diamanten mit der Güte des Schliffs deutlich ansteigt.
Im Frequenzplot sieht man zudem welcher Schnitt bei gegebenem Preis am häufigsten vorkommt
Aufgabe 3.3: Daten transformieren
Laden Sie das Paket DA.students und betrachten Sie die Datentabelle dat.studenten.
- Definieren Sie die neuen Merkmale:
DiffAlterMut,DiffAlterVat,DiffAlterMV, die den Altersunterschied der Befragten zur Mutter, zum Vater und die Differenz zwischen dem Alter des Vaters und der Mutter enthalten. - Benennen Sie die beiden Merkmale
DiffAlterMut,DiffAlterVatum inDiffAlterMbzw.DiffAlterV. - Sortieren Sie die Daten absteigend nach der größten Differenz zwischen dem Alter des Vaters und der Mutter.
- Ermitteln Sie die sieben kleinsten Frauen und die sieben kleinsten Männer.
Lösung
# Pakete laden:
library(pacman)
p_load(tidyverse, DA.students)
# i)
dat.neu <- dat.studenten |> mutate(DiffAlterMut = AlterM - Alter,
DiffAlterVat = AlterV - Alter,
DiffAlterMV = AlterV - AlterM)# ii)
dat.neu <- dat.neu |> rename(DiffAlterM = DiffAlterMut,
DiffAlterV = DiffAlterVat) |>
select(-c(NoteMathe, MatheZufr, Wohnform, AlterV, AlterM))Bemerkung: Für diese Aufgabe werden nicht alle Daten benötigt, um es übersichtlicher zu gestalten nutzt man select(), dies ist aber eigentlich nicht notwendig!
# iii)
dat.neu |> arrange(desc(DiffAlterMV))       # Vater älter als Mutter
# A tibble: 1,254 × 7
Alter Groesse Geschlecht AnzSchuhe DiffAlterM DiffAlterV DiffAlterMV
<dbl> <dbl> <fct> <dbl> <dbl> <dbl> <dbl>
1 25 180 männlich 15 32 62 30
2 21 163 weiblich 30 29 54 25
3 21 173 männlich 12 24 49 25
4 22 197 männlich 5 31 55 24
5 21 171 weiblich 20 29 51 22
6 21 170 männlich 6 20 41 21
7 28 180 männlich 5 13 34 21
8 21 183 männlich 9 29 48 19
9 24 179 männlich 10 25 44 19
10 21 181 männlich 7 20 38 18
# ℹ 1,244 more rowsdat.neu |> arrange(DiffAlterMV) # Mutter älter als Vater# A tibble: 1,254 × 7
Alter Groesse Geschlecht AnzSchuhe DiffAlterM DiffAlterV DiffAlterMV
<dbl> <dbl> <fct> <dbl> <dbl> <dbl> <dbl>
1 26 194 männlich 20 42 28 -14
2 23 181 weiblich 35 40 28 -12
3 23 181 männlich 10 32 22 -10
4 20 163 weiblich 10 35 25 -10
5 21 168 weiblich 40 44 34 -10
6 19 160 weiblich 15 43 34 -9
7 21 178 weiblich 30 40 31 -9
8 19 172 weiblich 15 39 30 -9
9 25 173 männlich 10 36 28 -8
10 20 183 männlich 4 38 30 -8
# ℹ 1,244 more rowsdat.neu |> arrange(desc(abs(DiffAlterMV))) # absoluter Betrag# A tibble: 1,254 × 7
Alter Groesse Geschlecht AnzSchuhe DiffAlterM DiffAlterV DiffAlterMV
<dbl> <dbl> <fct> <dbl> <dbl> <dbl> <dbl>
1 25 180 männlich 15 32 62 30
2 21 163 weiblich 30 29 54 25
3 21 173 männlich 12 24 49 25
4 22 197 männlich 5 31 55 24
5 21 171 weiblich 20 29 51 22
6 21 170 männlich 6 20 41 21
7 28 180 männlich 5 13 34 21
8 21 183 männlich 9 29 48 19
9 24 179 männlich 10 25 44 19
10 21 181 männlich 7 20 38 18
# ℹ 1,244 more rows# iv)
dat.neu |> group_by(Geschlecht) |>
slice_min(Groesse, n = 7)# A tibble: 15 × 7
# Groups: Geschlecht [2]
Alter Groesse Geschlecht AnzSchuhe DiffAlterM DiffAlterV DiffAlterMV
<dbl> <dbl> <fct> <dbl> <dbl> <dbl> <dbl>
1 24 150 weiblich 10 26 36 10
2 21 150 weiblich 20 25 29 4
3 20 151 weiblich 12 27 27 0
4 23 151 weiblich 10 26 37 11
5 24 151 weiblich 50 34 30 -4
6 25 151 weiblich 90 34 30 -4
7 21 152 weiblich 20 28 34 6
8 19 155 männlich 10 30 31 1
9 22 165 männlich 5 37 41 4
10 19 165 männlich 4 30 31 1
11 28 165 männlich 12 32 31 -1
12 21 165 männlich 4 32 39 7
13 25 166 männlich 3 25 30 5
14 19 168 männlich 12 28 29 1
15 21 168 männlich 5 39 44 5Aufgabe 3.4: Graph einer Funktion
In dieser Aufgaben sollen Sie Graphen von mathematischen Funktionen mit R erzeugen.
Gegeben sind die drei Funktionen
\[\begin{aligned} f(x) = \mathrm{e}^x, \qquad g(x) = \ln(x), \end{aligned}\]
sowie die Winkelhalbierende \(h(x) = x\).
- Erstellen Sie eine Datentabelle mit der Sie die obigen Funktionen im Intervall \([-3, 3]\) mit ggplot2 darstellen können.
- Erstellen Sie nun eine Grafik in der die Graphen aller drei Funktionen zu sehen sind.
- Färben Sie die Graphen und zeichen sie diese mit einer etwas dickeren Strichstärke als dem Standard.
- Schauen Sie sich nun die erzeugte Datentabelle an. Was fällt auf?
Der Logarithmus ist die Spiegelung der Exponenatialfunktion an der Winkelhalbierenden, da es Umkehrfunktionen voneinender sind. In der Grafik, die Sie eben erstellt haben ist das aufgrund der Skalierung (die \(y\)-Achse ist gestaucht) nicht zu sehen.
- Mit welcher Funktion (aus dem ggplot-Unmiversum) können Sie die Koordinaten nun so zurechtschneiden, dass das Koordinatensystem in \(x\)- wie \(y\)-Richtung die gleiche Dimension hat (z.B. jeweils von -3 bis 3)?
Lösung
library(pacman)
p_load(tidyverse)

## Zuerst muss der Datensatz erzeugt werden:

daten <- tibble(x = seq(-3, 3, 0.001), # kleine Schrittweite, damit möglicht schön
                EXP = exp(x),
                LN = log(x))

## Die Grafik

daten |> ggplot(aes(x=x)) +
         geom_line(aes(y = EXP), color = "blue", linewidth = 1.2) +
         geom_line(aes(y = LN), color = "red", linewidth = 1.2) +
         geom_line(aes(y = x), linewidth = 1.2) +
         labs(y = "y") # im Original endete die Zeile mit " +" (Syntaxfehler)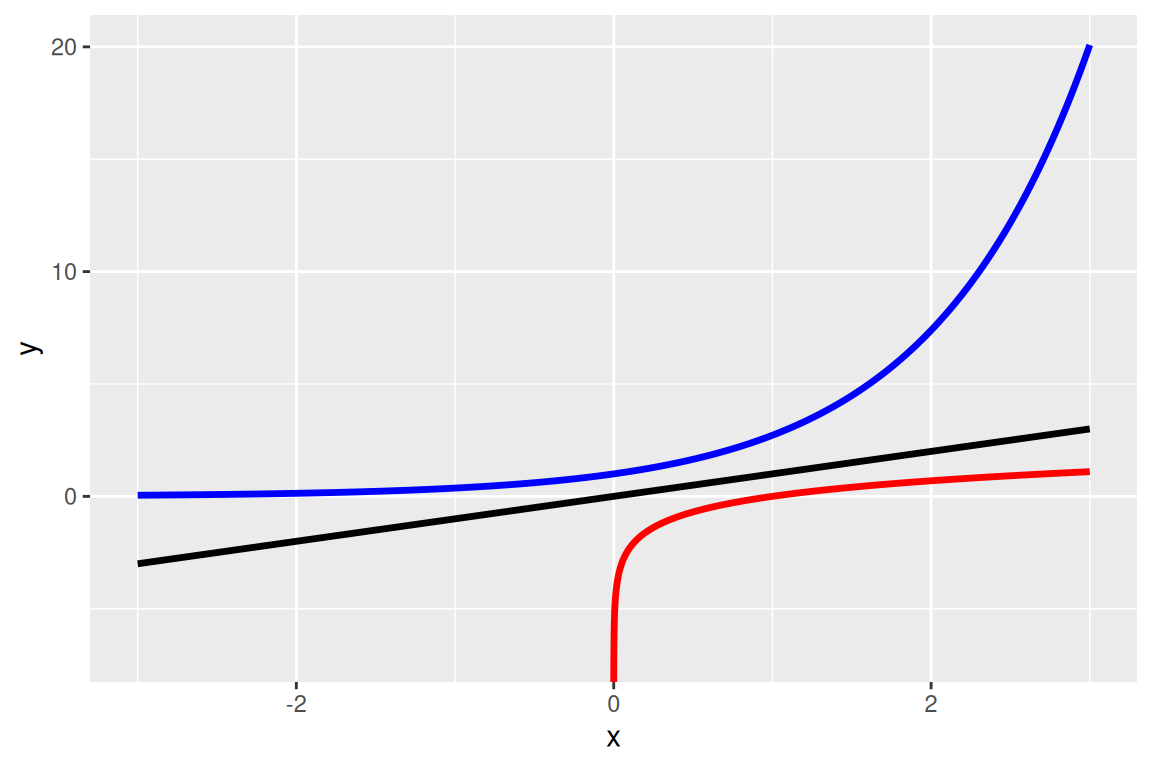
Bemerkungen:
Im Tibble können Sie beliebig viele Spalten generiert werden. Im obigen Fall erzeugen wir drei Spalten, die \(x\)-Koordinate in
x, und die zugehörigen Funktionswerte der Exponentialfunktion (EXP) bzw. der Logarithmusfunktion (LOG).Da in der Grafik das Merkmal
xfür alle drei Graphen benötigt wird (die \(x\)-Koordinate), kann man dies in die ggplot-Funktion schreiben. Die Funktionswerte jedoch sind für jede geometrsiche Funktion verschieden, weswegen diese in den geometrischen Funktionen angegeben werden müssen.Die Liniendicke und die Farbe stehen jeweils außerhalb der Funktion
aes(), da deren Ausprägungen nicht von der Ausprägung eines Merkmals abhängig sind.
Es fällt auf, dass das im Merkmal LN für die negativer x-Werte NaNs erzeugt wurden. Das Gute an der Sache ist, dass sich das nicht auf den Graphen auswirkt!
daten |> ggplot() +
         geom_line(aes(x = x, y = EXP), color = "blue", linewidth = 1.2) +
         geom_line(aes(x = x, y = LN), color = "red", linewidth = 1.2) +
         geom_line(aes(x = x, y = x), linewidth = 1.2) +
         labs(y = "y") +
         coord_cartesian(xlim=c(-3,3), ylim =c(-3,3))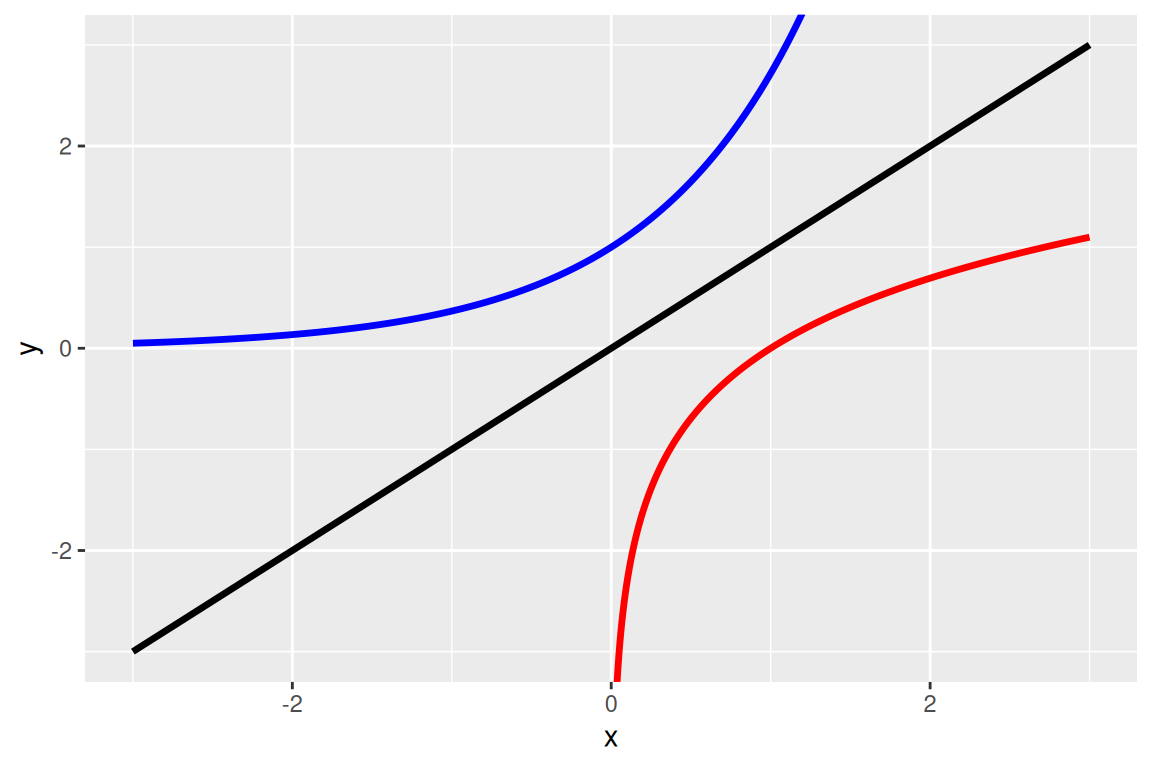
Mit der Funktion coord_cartesian() kann man einen beliebigen Bereich auswählen und die Funktion auf diesen zuschneiden.
Aufgabe 3.5: Farben in R
In R gibt es viele Möglichkeiten die Farben von Grafiken zu verändern. Die wichtigste wird durch das Paket colorspace zur Verfügung gestellt, das eine Vielzahl von wichtigen Farbpaletten bereitstellt. Dies soll jedoch später in einer eigenen Aufgabe besprochen werden.
Farben werden durch Zeichenketten der Form #RRGGBB bzw. #RRGGBBAA repräsentiert, wobei RR für einen Rotwert, GG für einen Grünwert und BB für einen Blauwert stehen. Das nicht notwendige, aber mögliche AA steht für einen Alphawert, der die Transparenz kodiert. Alle Werte werden im Hexadezimalsystem angegeben, das heißt sie gehen von 00 bis FF.
# Pakete laden:
library(pacman)
p_load(tidyverse, patchwork)
g1 <- mpg |> ggplot(aes(x = cty, y = hwy)) +
geom_point(color = "#0000FF") # blau
g2 <- mpg |> ggplot(aes(x = displ, y = hwy)) +
geom_point(color = "#FF000033") # rot transparent
g3 <- mpg |> ggplot(aes(x = displ, y = cty)) +
geom_point(color = "#FFAA00") # orange
(g1|g2|g3)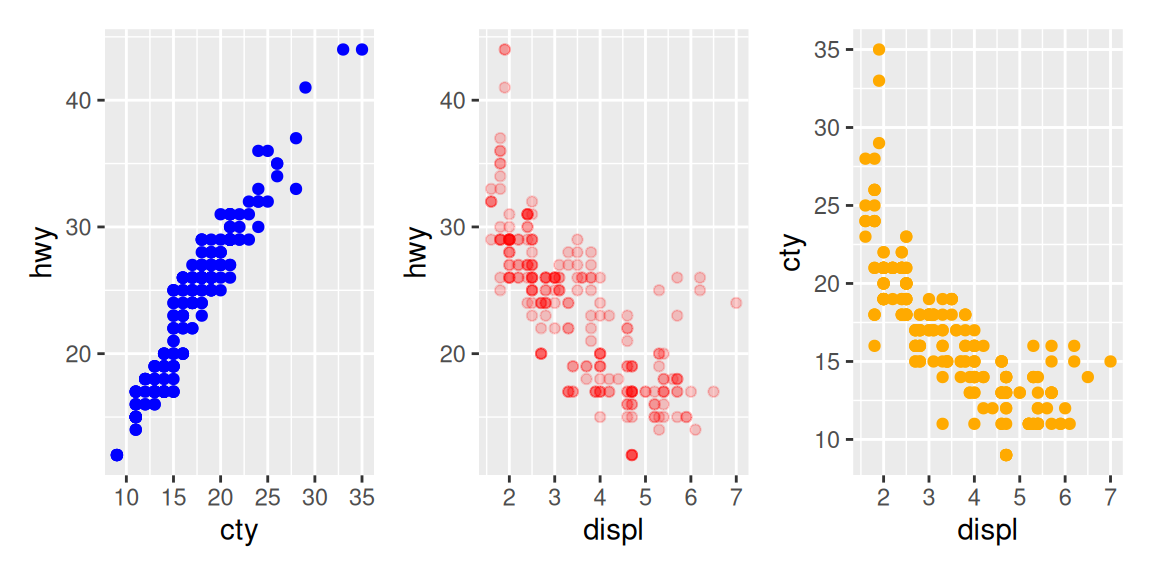
Vordefinierte Farben:
In R gibt es 657 vordefinierte Farben, die einen Namen haben. Diese finden Sie im R Color Cheat Sheet (moodle). Alle Farbnamen kann man mit der folgenden Funktion sichtbar machen:colors() # insgesamt 657 Farbnamen, 502 verschiedenecolors()[1:12] # die ersten 12:[1] "white" "aliceblue" "antiquewhite" "antiquewhite1" [5] "antiquewhite2" "antiquewhite3" "antiquewhite4" "aquamarine" [9] "aquamarine1" "aquamarine2" "aquamarine3" "aquamarine4"In der folgenden Grafik sind alle vordefinierten Farben zu sehen. Die Zahl an der \(x\)-Achse entspricht der Stelle im Vektor
colors().
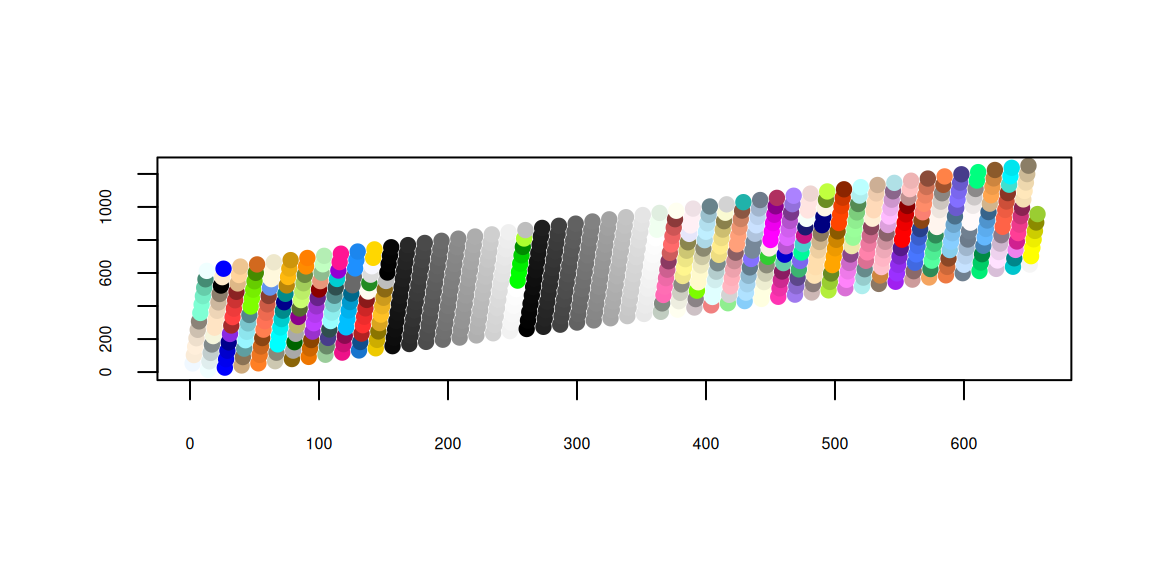
Die Funktion
rgb():Mit Hilfe der Funktion
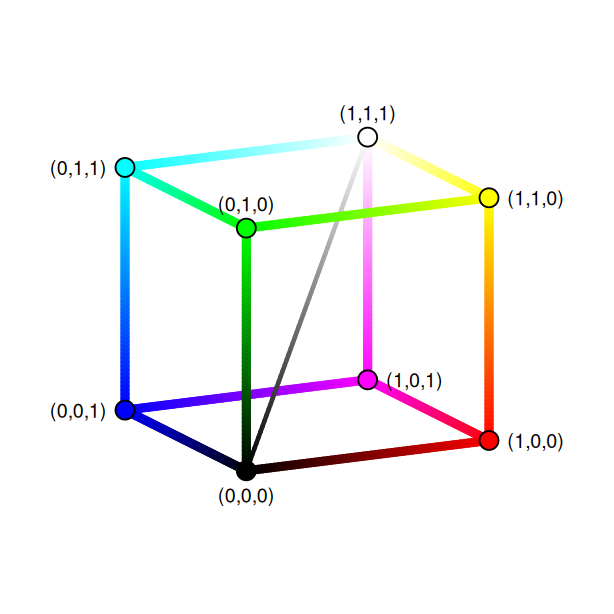
rgb(), was für red, green, blue steht, können Farben auf einfache Weise generiert werden: die Argumente der Funktion sindred,green,blue,alpha,names = NULLundmaxColorValue = 1. Diese können vektoriell verwendet werden, um eine ganze Palette von Farben zu erzeugen. Dabei variieren nun die Werte standardmäßig zwischen 0 und 1, können aber aber durch Ändern des ArgumentsmaxColorValueauch zwischen 0 und einem beliebigen anderen Wert (oft wird der Wert 255 verwendet) variieren.Durch diese Parametrisierung erhält man einen Farbwürfel, dessen Ecken und Kanten im Bild rechts zu sehen sind. Die Diagonale, bei der die R-,G- und B-Werte jeweils gleich sind, enthält die Grautöne.
die Funktion
hsv():Analog zur Funktion
rgb()können mit der Funktionhsv(), was für hue, saturation, value steht, Farben definiert werden. Die Argumente der Funktion sindh = 1,s = 1,v = 1, sowiealpha, der Transparenz. Alle Argumente sind Zahlenwerte aus dem Intervall \([0, 1]\). Im Gegensatz zum RGB-Farbraum sind der HSV-Farbraum und auch der HCL-Farbraum auf die Wahrnehmung des Menschen ausgelegt. Diese beiden Farbräume eignen sich daher deutlich besser für Grafiken.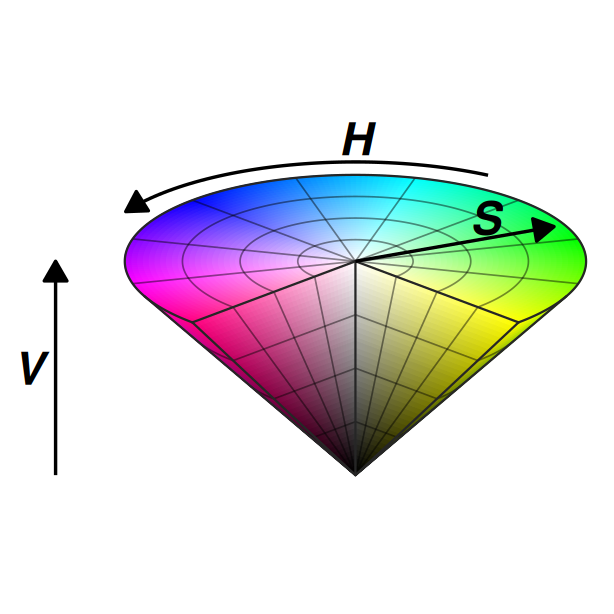
die Funktion
hcl():
Auch mit der Funktionhcl(), was für hue, color, luminance steht, können Farben definiert werden. Die Argumente der Funktion sindh = 0aus \([0, 360]\),c = 35,l = 85aus \([0, 100]\),alphaaus \([0, 1]\), der Transparenz undfixup = TRUE. Welchen Wertcannehmen kann, hängt vonhundlab. Das Paketcolorspacebasiert auf dem HCL-Farbraum und bietet optimale Werkzeuge um Farbpaletten zu erzeugen.
Welche Farben werden in den Vektoren
r1undr2erzeugt?(r1 <- rgb(seq(0, 1, 0.1), 0, 1))[1] "#0000FF" "#1A00FF" "#3300FF" "#4D00FF" "#6600FF" "#8000FF" "#9900FF" [8] "#B300FF" "#CC00FF" "#E600FF" "#FF00FF"r2 <- rgb(seq(0,1,0.1), seq(0,1,0.1), seq(0,1,0.1))Überlegen Sie sich das Ergebnis anhand der Grafik zu den RGB-Farben.
Erzeugen sie mit der Funktion
hsv()jeweils einen Blau- und einen Gelbton. Variieren Sie das Argumentvvon 0 bis 1 und stellen Sie das Ergebnis in einer einfachen Grafik dar, zum Beispielbarplot(1:12, col = 1:12)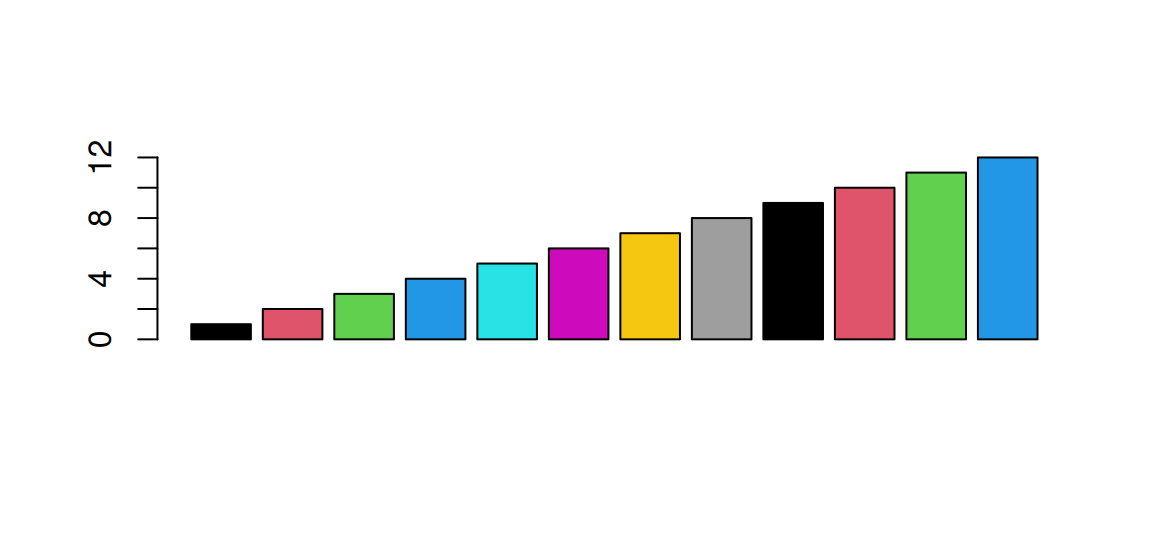
wobei natürlich die erzeugten Farben gewählt werden sollen.
Wie erzeugt man mit
hsv()die Grautöne?
Für die kommenden Aufgaben benötigen Sie das Paket DA.students.
Erzeugen Sie mehrere Farbvektor mit zwei nicht zu saturierter Farben. Erstellen Sie nun einen Boxplot bei dem das Geschlecht auf der \(x\)-Achse und die Anzahl der Schuhe auf der \(y\)-Achse aufgetragen werden. Färben Sie die Boxplots mit den von Ihnen generierten Farben.
Nutzen Sie sowohl die vordefinierten Farben als auch die Funktionen
rgb().Was macht die Funktion
rev()? Inwiefern hilft Ihnen das ggf. bei der Vergabe von Farben?
Bemerkungen:
Sowohl der HSV- als auch der HCL-Farbraum orientieren sich beide an der Wahrnehmung des Auges und sind daher prinzipiell besser für Grafiken geeignet, insbesondere wenn (kontinuierliche) Farbpaletten benötigt werden.
Für einfache Grafiken (zum Beipspiel einfach gefärbte Graphen, ggf. transparente einfarbige Streudigramme, ist auch die Funktion
rgb()gut geeignet.Häufig kommt es insbesondere bei kategorialen Daten vor, dass man Farbpaletten braucht, wobei nicht ohne weiteres klar ist, wie viele Farben benötigt werden (zum Beispiel Anzahl der Automarken im
mpg-Datensatz oder die Anzahl der Wohnformen imdat.studenten-Datensatz, etc.). Hier ist es notwendig einen anderen Weg zur Änderung der Farben zu wählen. Dies geschieht in der nächsten Aufgabe!
Lösung
- Bei
r1läuft man von \((0, 0, 1)\) blau nach \((1, 0, 1)\) magenta und teilt das Intervall in 10 Farben auf. - Bei
r2durchläuft man die Diagonale bei denen r, g und b immer den gleichen Wert haben, das heißt von schwarz nach weiß durch Grautöne.
- Bei
Untersuchung von
v:hsv(seq(0,1,length.out = 13))[1] "#FF0000" "#FF8000" "#FFFF00" "#80FF00" "#00FF00" "#00FF80" "#00FFFF" [8] "#0080FF" "#0000FF" "#8000FF" "#FF00FF" "#FF0080" "#FF0000"plot(1:13, 1:13, pch = 19, col = hsv(h = seq(0,1,length.out = 13)), cex = 2)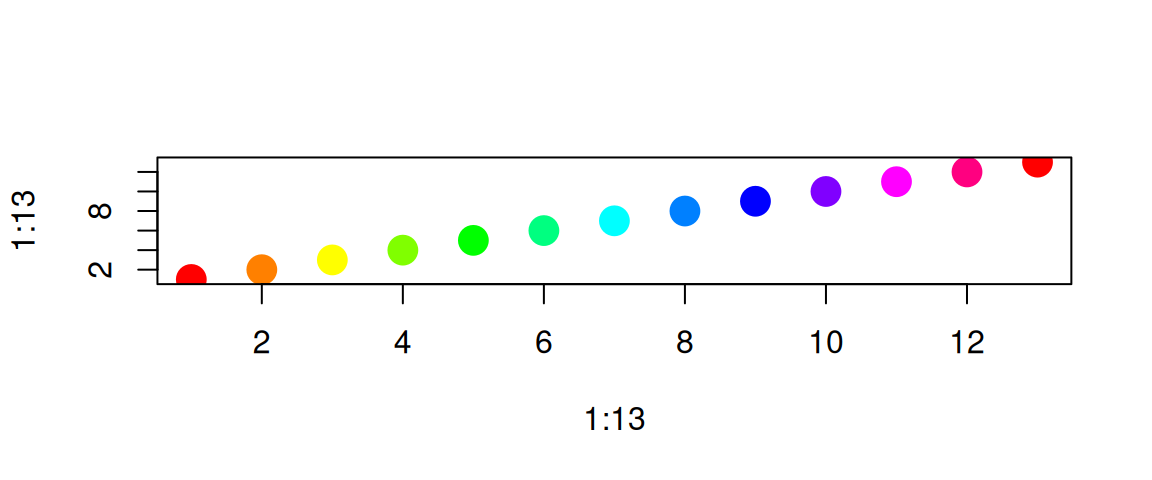
Man erkennt, dass der 3. Punkt gelb ist und der 9. Punkt blau: Damit kann man folgende Grafiken erzeugen:
hsv(seq(0,1,length.out = 13))[1] "#FF0000" "#FF8000" "#FFFF00" "#80FF00" "#00FF00" "#00FF80" "#00FFFF" [8] "#0080FF" "#0000FF" "#8000FF" "#FF00FF" "#FF0080" "#FF0000"gelb <- seq(0,1,length.out = 13)[3] blau <- seq(0,1,length.out = 13)[9] plot(1:11, 1:11, pch = 19, col = hsv(h = gelb, v = seq(0,1,0.1)), cex = 2)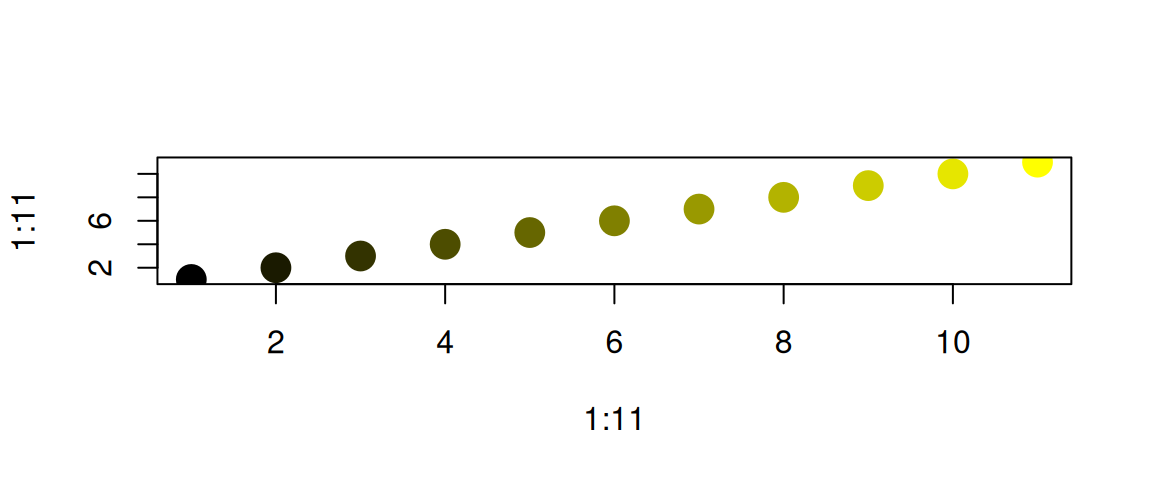
plot(1:11, 1:11, pch = 19, col = hsv(h = blau, v = seq(0,1,0.1)), cex = 2)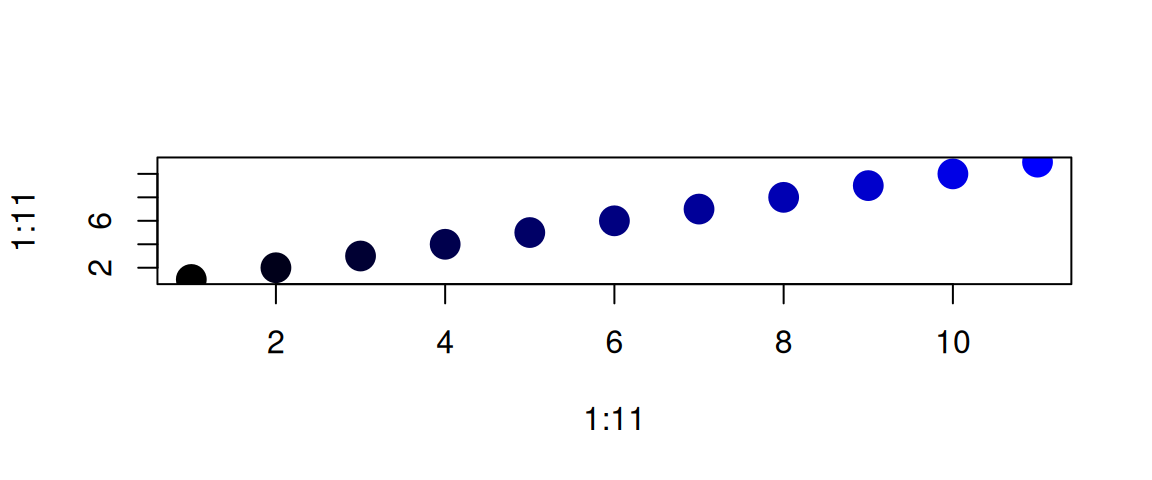
Für die Grautöne muss
s = 0gesetzt werden, der Wert vonhspielt keine Rolle!hsv(s = 0, v = 0) # liefert schwarz[1] "#000000"hsv(s = 0, v = 1) # liefert weiß[1] "#FFFFFF"library(pacman) p_load(tidyverse, DA.students, patchwork) mycol11 <- c(rgb(1, 0, 0.5, 0.3), # Rotton transparent rgb(0, 0.5, 1, 0.3)) # Blauton transparent mycol12 <- c(rgb(0, 0.5, 1, 0.6), # Blauton weniger transparent rgb(1, 0, 0.5, 0.6)) # Rotton weniger transparent g1 <- dat.studenten |> ggplot(aes(x = Geschlecht, y = AnzSchuhe)) + geom_boxplot(color = mycol11, fill = rev(mycol12)) # falsche Reihenfolge, rev() dreht Vektor um. ## sich aus der Fabpalette passende Farben zu suchen ist ggf. etwas mühsam. ## für einfache Grafiken, aber ok. g2 <- dat.studenten |> ggplot(aes(x = Geschlecht, y = AnzSchuhe)) + geom_boxplot(color = c("darkred", "darkblue"), fill = c("red", "blue")) (g1|g2)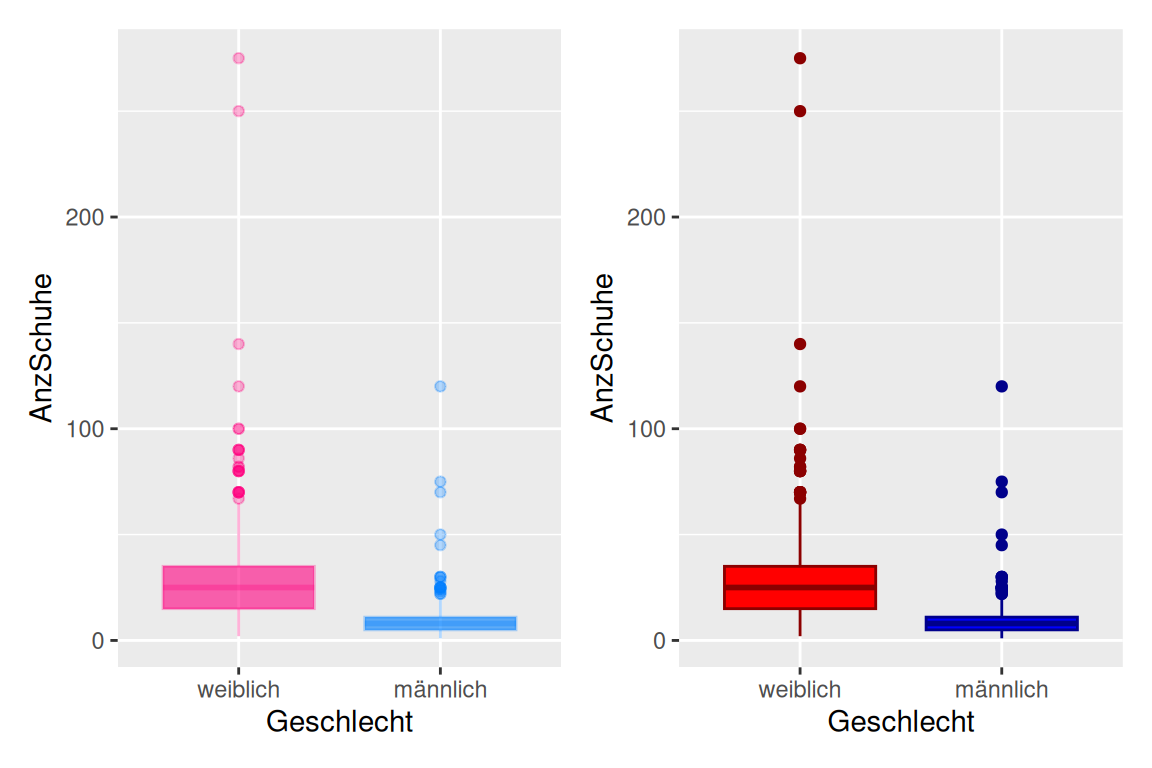
# die hier gewählten Farben sind zu saturiert und damit eher ungeeignet!Die Funktion
rev()kehrt die Reihenfolge der Einträge eines Vektors um. Damit kann natürlich auch die Reihenfolge der Farben einer Palette umgedreht werden.farben <-c("blue", "red", "green", "black") rev(farben)[1] "black" "green" "red" "blue"