## Laden von Tidyverse, das brauchen wir immer...

library(pacman)
p_load(tidyverse) Übung vom 27.10.2026
Wie untersucht man Daten(tabellen)
Als Beispiel nehmen wir den Datensatz Salaries aus dem Paket carData. Da dieser Datensatz ein Data Frame ist und kein Tibble wandeln wir diesen um (und benennen ihn anders).
p_load(carData)

salaries <- as_tibble(Salaries)
Wie sehen die Daten aus?
Die Funktion glimpse() gibt einen ersten Überblick. Die Funktion summary() eine Zusammnfassung geeigneter Kenngrößen.
glimpse(salaries)Rows: 397
Columns: 6
$ rank <fct> Prof, Prof, AsstProf, Prof, Prof, AssocProf, Prof, Prof,…
$ discipline <fct> B, B, B, B, B, B, B, B, B, B, B, B, B, B, B, B, B, A, A,…
$ yrs.since.phd <int> 19, 20, 4, 45, 40, 6, 30, 45, 21, 18, 12, 7, 1, 2, 20, 1…
$ yrs.service <int> 18, 16, 3, 39, 41, 6, 23, 45, 20, 18, 8, 2, 1, 0, 18, 3,…
$ sex <fct> Male, Male, Male, Male, Male, Male, Male, Male, Male, Fe…
$ salary <int> 139750, 173200, 79750, 115000, 141500, 97000, 175000, 14…summary(salaries) rank discipline yrs.since.phd yrs.service sex
AsstProf : 67 A:181 Min. : 1.00 Min. : 0.00 Female: 39
AssocProf: 64 B:216 1st Qu.:12.00 1st Qu.: 7.00 Male :358
Prof :266 Median :21.00 Median :16.00
Mean :22.31 Mean :17.61
3rd Qu.:32.00 3rd Qu.:27.00
Max. :56.00 Max. :60.00
salary
Min. : 57800
1st Qu.: 91000
Median :107300
Mean :113706
3rd Qu.:134185
Max. :231545 Grafische Darstellung der Daten (ein Merkmal)
Die Skalenniveaus geben vor welche Grafiken wir verwenden. Im obigen Beispiel sind rank, discipline und sex kategoriale Merkmale, yrs.since.phd, yrs.servie und salarysind metrisch.
Für die kategorialen Merkmale nehmen wir Säulendiagramme, für die metrischen Histogramme, wobei wir bei den Histogrammen darauf achten, dass die Anzahl der Bins (Argument: bins=) oder die Breite der Bins (Argument: binwidth=) sinnvoll gewählt ist. Gegebenenfalls müssen wir dies ein wenig ausprobieren bzw. aus den Daten erschließen.
p_load(patchwork) # um Grafiken zu positionieren

k1 <- salaries |> ggplot(aes(x = rank)) + geom_bar()
k2 <- salaries |> ggplot(aes(x = discipline)) + geom_bar()
k3 <- salaries |> ggplot(aes(x = sex)) + geom_bar()

m1 <- salaries |> ggplot(aes(x = yrs.service)) + geom_histogram(binwidth = 1)
m2 <- salaries |> ggplot(aes(x = yrs.since.phd)) + geom_histogram(binwidth = 1)
m3 <- salaries |> ggplot(aes(x = salary)) + geom_histogram(bins = 40)

(k1|k2|k3)/(m1|m2|m3)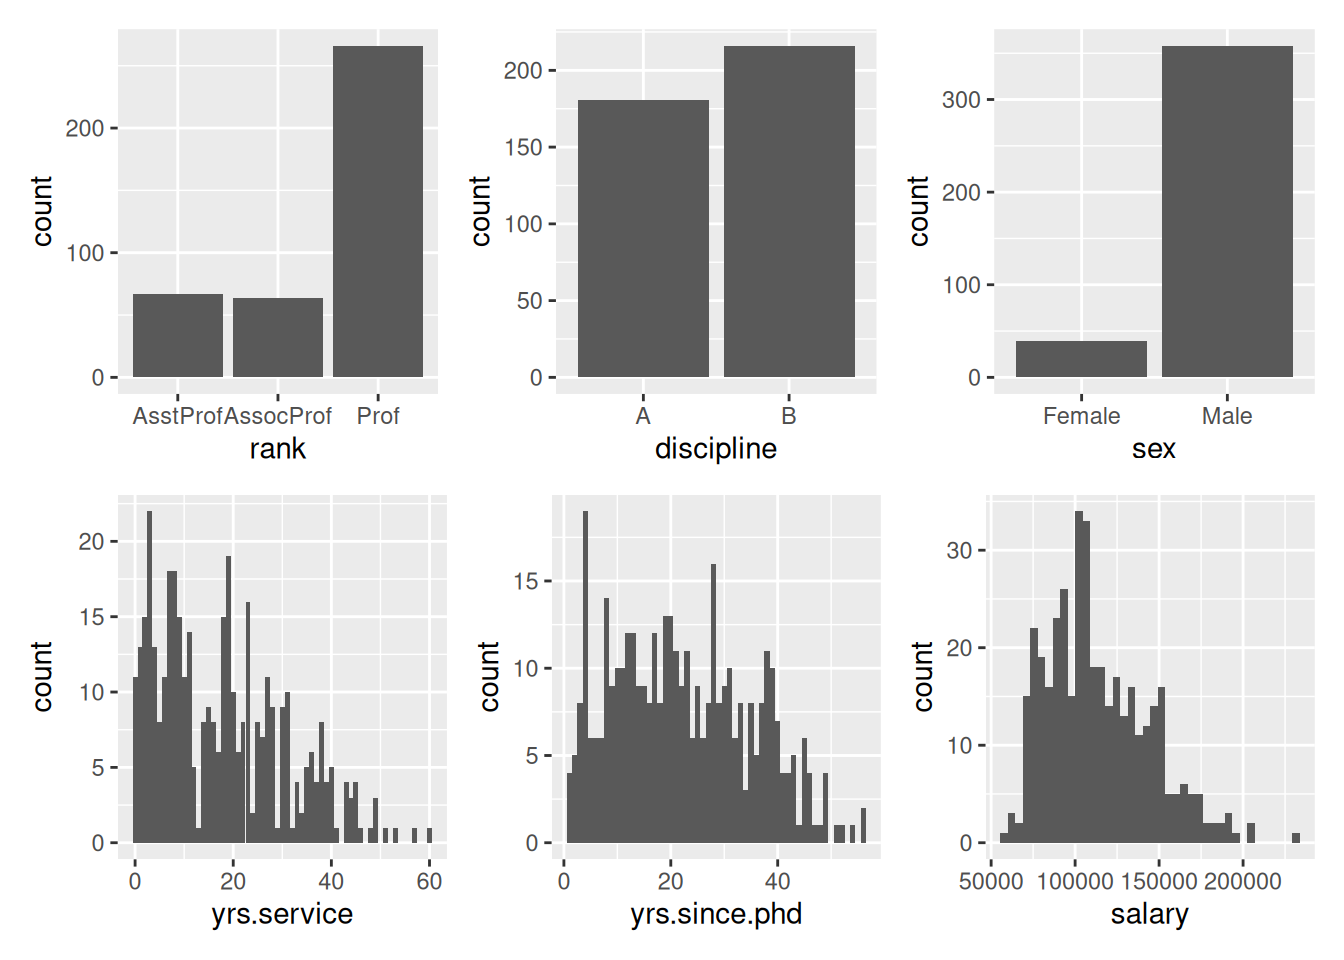
Grafische Darstellung der Daten (zwei Merkmale)
Um einen Überblick über alle Paare zu erhalten können wir das Paket GGallynutzen. Dies stellt die Funktion ggpairs() bereit.
p_load(GGally)
ggpairs(salaries)
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.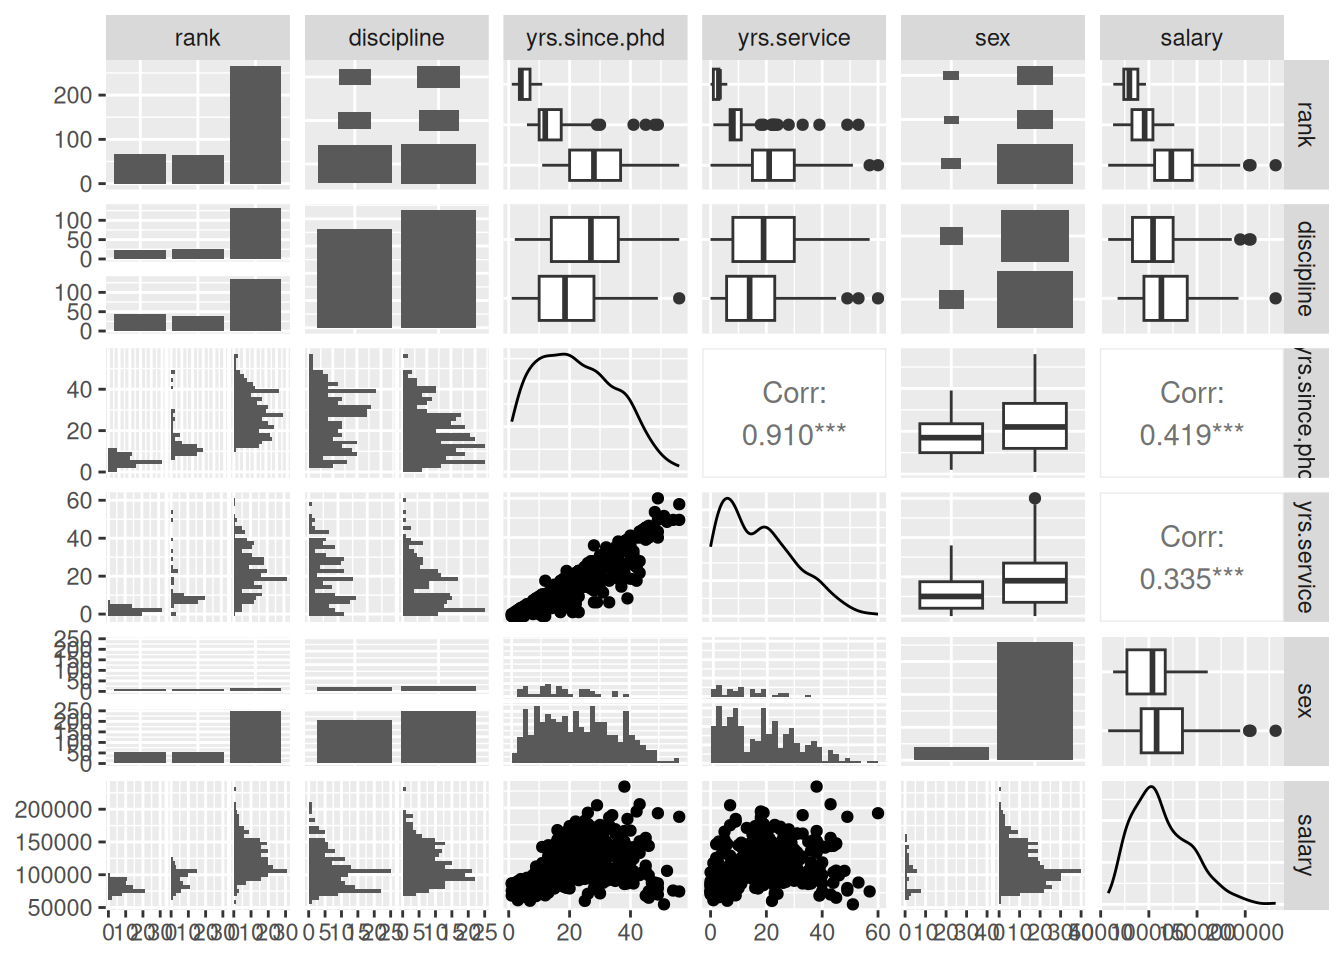
Aus dieser Grafik kann man nun entnehmen welche Grafiken für die weitere EDA interessant sind. Zum Beispiel
p_load(ggmosaic)
salaries |> ggplot() +
            geom_mosaic(aes(product(sex, rank), fill = sex))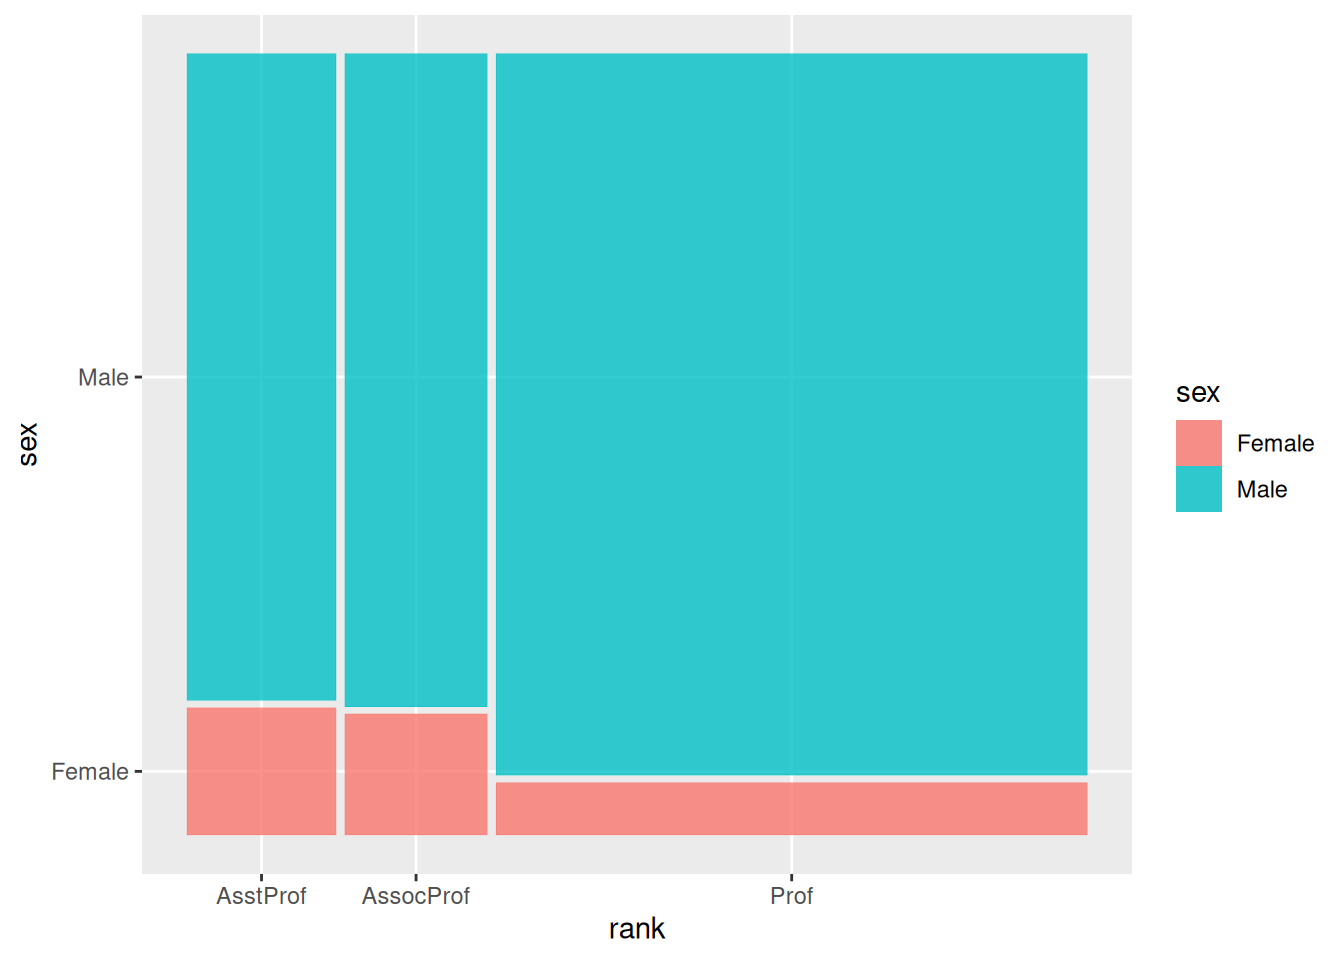
salaries |> ggplot() +
            geom_boxplot(aes(sex, salary))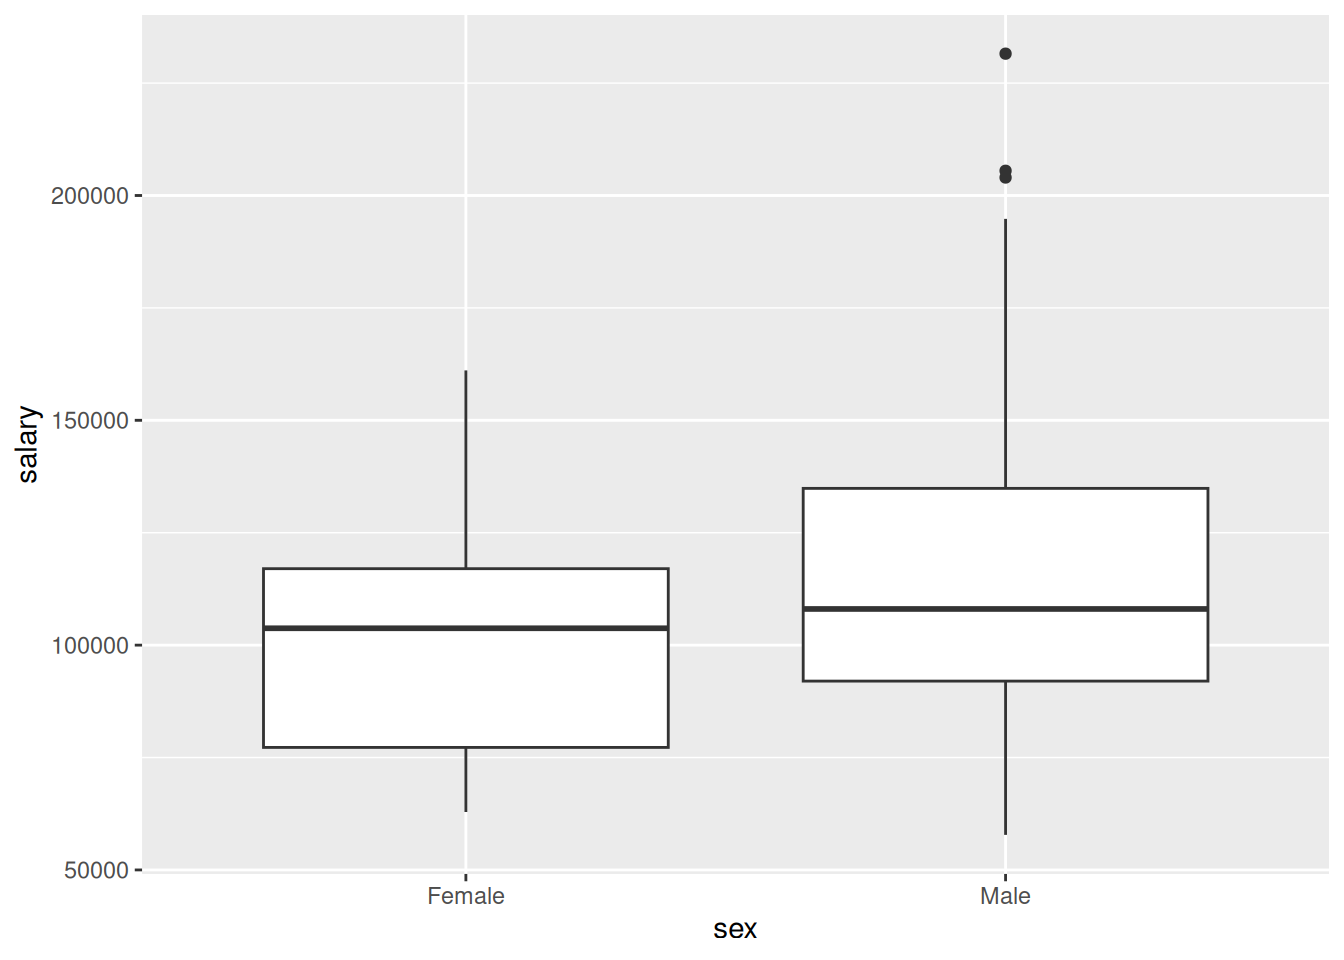
Weitere Fragen
Warum weight= in geom_*-Funktionen ?
p_load(DA.students)
dat.studenten |> ggplot(aes(x = Wohnform)) + geom_bar()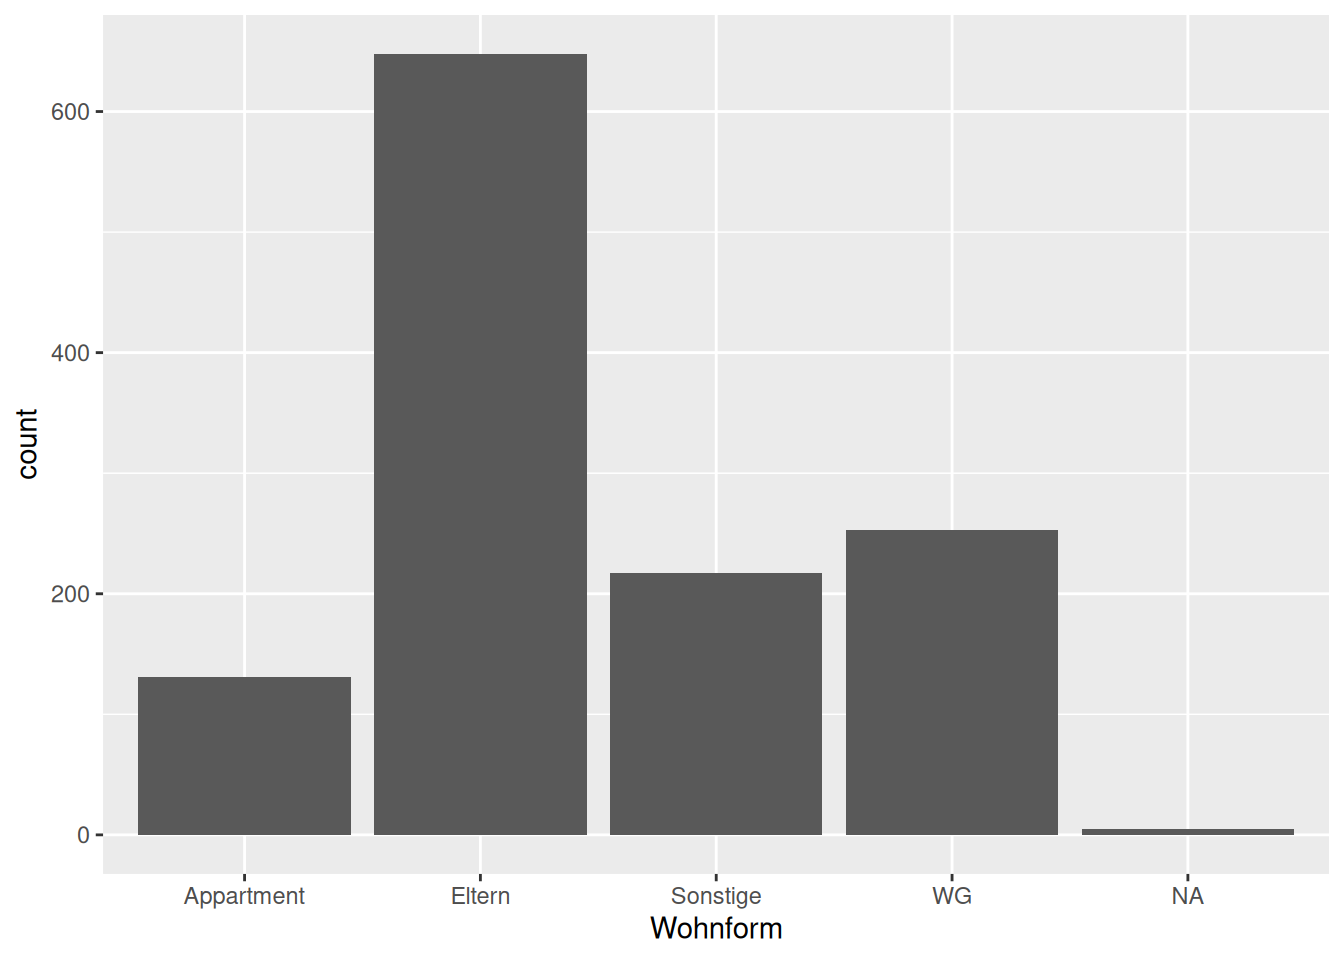
Die Funktion geom_bar() zählt wie oft jede der Wohnformen im Datensatz dat.studenten vorkommt und stellt diese dar. Sind Daten nun aggregiert muss das Argument weight= verwendet werden.
## Erstellen der aggregierten Daten:
## (Der Teil muss jetzt noch nicht verstanden werden)
da.aggr <- dat.studenten |> group_by(Wohnform) |>
                          summarize(n = n())
da.aggr
# A tibble: 5 × 2
Wohnform n
<chr> <int>
1 Appartment 131
2 Eltern 648
3 Sonstige 217
4 WG 253
5 <NA> 5da.aggr |> ggplot() + geom_bar(aes(x = Wohnform, weight = n))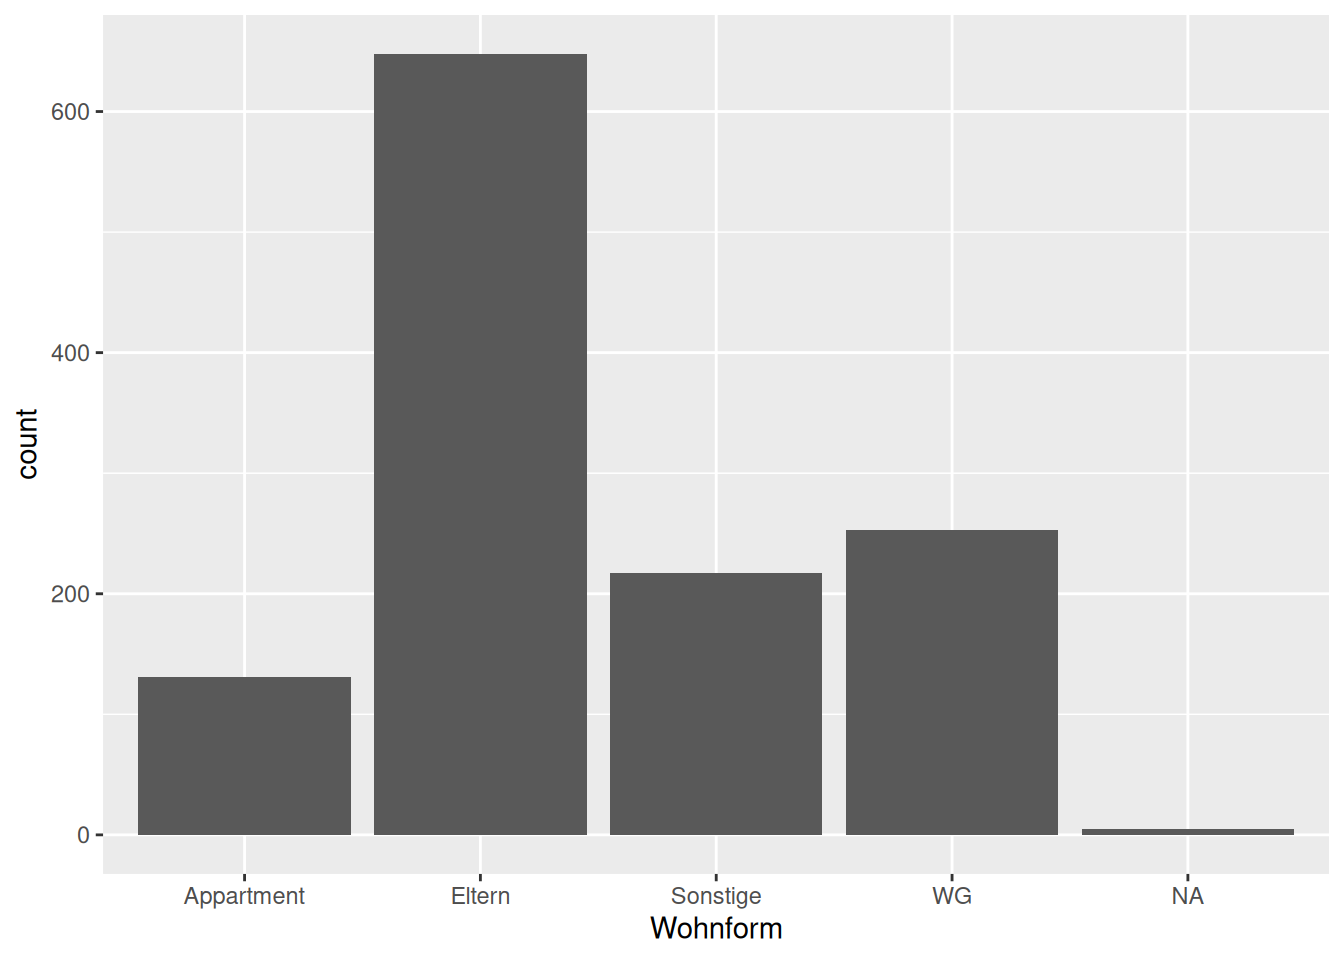
Die Funktion paste() und paste0()
## Vektoren erstellen:

(x <- 1:5)
[1] 1 2 3 4 5(y <- LETTERS[1:5])[1] "A" "B" "C" "D" "E"(z <- c(1,2,3,NA, NA, 5))[1] 1 2 3 NA NA 5paste(x,y)[1] "1 A" "2 B" "3 C" "4 D" "5 E"paste0(x,y)[1] "1A" "2B" "3C" "4D" "5E"paste(x,y, sep = "-")[1] "1-A" "2-B" "3-C" "4-D" "5-E"paste(x,y, sep = "-", collapse = "+")[1] "1-A+2-B+3-C+4-D+5-E"Mit [] hinter einem Vektor wählt man die Elemente des Vektors aus. Entweder durch die Position im Vektor
y[c(4,2,2,2)][1] "D" "B" "B" "B"oder mit Hilfe eines logischen Vktors, der die gleiche Länge haben muss wie der Vektor aus dem Elemente ausgewählt werden.
y[c(TRUE, FALSE, TRUE, TRUE, FALSE)][1] "A" "C" "D"y[y > 2][1] "A" "B" "C" "D" "E"Dabei werden NAs in einem der beiden Vektoren als NAs wiedergegeben.
zahlen          <- 11:18
zahlen_mit_na   <- c(11, 12, NA, 14, NA, 16, 17, 18)

zahlen > 16
[1] FALSE FALSE FALSE FALSE FALSE FALSE TRUE TRUEzahlen[zahlen > 16][1] 17 18zahlen_mit_na[zahlen_mit_na > 16][1] NA NA 17 18zahlen[zahlen_mit_na > 16][1] NA NA 17 18Der :-Operator
2.3:9[1] 2.3 3.3 4.3 5.3 6.3 7.3 8.3Der Doppelpunktoperator erzeugt Vektoren, der Start ist links von :, das maximale Ende rechts von :.