Lösungen Aufgaben 4

Aufgabe 4.1: Häufigkeiten

Ein Einzelhändler registriert für einen Exklusivartikel im Verlauf von \(30\) Verkaufstagen folgende Verkaufszahlen:

Tag 1 2 3 4 5 6 7 8 9 10
Anzahl 5 2 3 0 0 1 3 6 0 2
Tag 11 12 13 14 15 16 17 18 19 20
Anzahl 1 0 1 0 2 3 5 1 0 0
Tag 21 22 23 24 25 26 27 28 29 30
Anzahl 3 5 3 1 0 0 0 6 3 1
  1. Berechnen Sie die absoluten und relativen Häufigkeiten der Ausprägungen sowie die absolute kumulierte Häufigkeit für \(x=4\), zuerst händisch, dann mit R.
  2. Erstellen Sie das Histogramm mithilfe der absoluten Häufigkeiten und zwar sowohl mit Bleistift und Papier als auch mit R.

Lösung

  1. \(j\) 1 2 3 4 5 6
    \(a_j\) 0 1 2 3 5 6
    \(h_j\) 10 6 3 6 3 2
    \(H_j\) 10 16 19 25 28 30
    \(f_j\) \({10}/{30}\) \({6}/{30}\) \({3}/{30}\) \({6}/{30}\) \({3}/{30}\) \({2}/{30}\)
    \(F_j\) \({10}/{30}\) \({16}/{30}\) \({19}/{30}\) \({25}/{30}\) \({28}/{30}\) 1

    \[h(4) = 0, \qquad f(4) = 0, \qquad H(4) = 25, \qquad F(4) = {25}/{30}\]

  2. library(tidyverse)
    Anzahl <- c(5, 2, 3, 0, 0, 1, 3, 6, 0, 2, 1, 0, 1, 0, 2, 
                3, 5, 1, 0, 0, 3, 5, 3, 1, 0, 0, 0, 6, 3, 1)
    
    Anzahl |> tibble() |>  
      ggplot(aes(x=Anzahl)) +  
          geom_histogram(alpha = 0.8, binwidth  = 1) +
          labs(x = "Anzahl Verkäufe", y = "Häufigkeiten") 

Aufgabe 4.2: Daten filtern

Bemerkungen:

  • Für diese Aufgabe benötigen Sie den Datensatz flights aus dem Paket nycflights23, das Sie entweder über RStudio oder mit Hilfe des Pakets pacman und der Funktion p_load() installieren müssen.

  • Nutzen Sie konsequent den Pipe-Operator!

  1. Wie viele Flüge enthält der Datensatz insgesamt?

  2. An welchem Tag gab es die größte Verspätung beim Abflug?

  3. Sind mehr Flüge zu früh abgeflogen und zu spät angekommen oder zu spät abgeflogen und zu früh angekommen?

  4. Wie viele der Flüge sind exakt pünktlich abgeflogen und angekommen? Wieviel Prozent aller Flüge entspricht das?

Lösung

library(pacman)
p_load(tidyverse, nycflights23)

#
flights
# A tibble: 435,352 × 19
    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
 1  2023     1     1        1           2038       203      328              3
 2  2023     1     1       18           2300        78      228            135
 3  2023     1     1       31           2344        47      500            426
 4  2023     1     1       33           2140       173      238           2352
 5  2023     1     1       36           2048       228      223           2252
 6  2023     1     1      503            500         3      808            815
 7  2023     1     1      520            510        10      948            949
 8  2023     1     1      524            530        -6      645            710
 9  2023     1     1      537            520        17      926            818
10  2023     1     1      547            545         2      845            852
# ℹ 435,342 more rows
# ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>,
#   tailnum <chr>, origin <chr>, dest <chr>, air_time <dbl>, distance <dbl>,
#   hour <dbl>, minute <dbl>, time_hour <dttm>
flights |> summarize(n = n()) # 435.352
# A tibble: 1 × 1
       n
   <int>
1 435352
# 
flights |> arrange(desc(dep_delay)) 
# A tibble: 435,352 × 19
    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
 1  2023    12    17     1953           1340      1813     2155           1543
 2  2023    10     1     1240            659      1781     1407            835
 3  2023     4    25     1201            659      1742     1315            818
 4  2023     2     7     2045           1700      1665     2352           2025
 5  2023     4    20      926            619      1627     1135            822
 6  2023    10    29      856            600      1616     1050            805
 7  2023     4    30     1818           1617      1561     2001           1820
 8  2023     3    17     2027           1830      1557     2346           2139
 9  2023     3    29      633            525      1508      820            700
10  2023     3    19     1154           1201      1433     1321           1335
# ℹ 435,342 more rows
# ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>,
#   tailnum <chr>, origin <chr>, dest <chr>, air_time <dbl>, distance <dbl>,
#   hour <dbl>, minute <dbl>, time_hour <dttm>
#
flights |> filter(dep_delay < 0, arr_delay >0) # 33.053
# A tibble: 33,053 × 19
    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
 1  2023     1     1      549            559       -10      905            901
 2  2023     1     1      619            620        -1      751            745
 3  2023     1     1      656            659        -3     1031           1020
 4  2023     1     1      657            659        -2     1001            946
 5  2023     1     1      701            705        -4     1011            953
 6  2023     1     1      726            730        -4     1054           1052
 7  2023     1     1      750            755        -5     1114           1109
 8  2023     1     1      757            800        -3     1013           1011
 9  2023     1     1      832            835        -3     1141           1115
10  2023     1     1      851            859        -8     1111           1108
# ℹ 33,043 more rows
# ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>,
#   tailnum <chr>, origin <chr>, dest <chr>, air_time <dbl>, distance <dbl>,
#   hour <dbl>, minute <dbl>, time_hour <dttm>
flights |> filter(dep_delay > 0, arr_delay < 0) # 45.028
# A tibble: 45,028 × 19
    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
 1  2023     1     1      503            500         3      808            815
 2  2023     1     1      520            510        10      948            949
 3  2023     1     1      547            545         2      845            852
 4  2023     1     1      613            600        13      834            836
 5  2023     1     1      626            620         6      928            941
 6  2023     1     1      636            630         6      926            935
 7  2023     1     1      653            650         3      811            818
 8  2023     1     1      702            656         6      951            957
 9  2023     1     1      704            700         4     1005           1018
10  2023     1     1      705            700         5      944           1000
# ℹ 45,018 more rows
# ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>,
#   tailnum <chr>, origin <chr>, dest <chr>, air_time <dbl>, distance <dbl>,
#   hour <dbl>, minute <dbl>, time_hour <dttm>
# oder:
# flights |> filter(dep_delay < 0 & arr_delay > 0) 

# 
flights |> filter(dep_delay == 0, arr_delay == 0) # 283
# A tibble: 283 × 19
    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
 1  2023     1     2      700            700         0      850            850
 2  2023     1     3     2100           2100         0       38             38
 3  2023     1     4     1100           1100         0     1256           1256
 4  2023     1     5      535            535         0      659            659
 5  2023     1     9     1715           1715         0     2044           2044
 6  2023     1    10     1715           1715         0     2037           2037
 7  2023     1    11     1730           1730         0     1956           1956
 8  2023     1    13     1217           1217         0     1339           1339
 9  2023     1    14     1115           1115         0     1433           1433
10  2023     1    15     1455           1455         0     1625           1625
# ℹ 273 more rows
# ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>,
#   tailnum <chr>, origin <chr>, dest <chr>, air_time <dbl>, distance <dbl>,
#   hour <dbl>, minute <dbl>, time_hour <dttm>
283 / 435352 * 100 # 0,065 %
[1] 0.06500487

Aufgabe 4.3: Daten transformieren

In der Datei umfrage2024.csv finden Sie Daten zu einer (fiktive) Umfrage. Ziel der Aufgabe ist es die Merkmale aufzuarbeiten, das heißt Einträge der Merkmale mit Hilfe der Funktion mutate() zu ändern. Nutzen Sie bitte konsequent die Pipe, die Funktion across() sowie die tidyselect-Funktionen.

  1. Lesen Sie die Datei umfrage2024.csv mit Hilfe von Import Dataset >> From Text (readr) ein und verschaffen Sie sich einen Überblick über die Daten. Achten Sie beim Einlesen auf den Merkmalsnamen und den Separator.
  2. Vereinheitlichen Sie die Groß- und Kleinschreibung in den Merkmalsnamen (letzten beiden Merkmale!).
  3. Löschen Sie alle Beobachtungen, die irgendwo ein NA haben, sowie alle Beobachtungen bei denen das Alter kleiner als 18 oder größer als 30 ist.
  4. Ändern sie bei den ersten drei Fragen (in einer Funktion!) die logischen Werte TRUE und FALSE zu ja und nein ab.
  5. Die nächsten fünf Merkmale haben die Ausprägungen 1, 2, 3, 4, 5. Ändern Sie diese so, dass die Ausprägungen von 0 bis 4 gehen, indem überall die Ausprägung um 1 erniedrigt wird.
  6. Die mit invers gekennzeichneten Merkmale sollen nun so von Ihnen verändert werden, dass die Numerierung umgekehrt wird, also 0 zu 4, 1 zu 3, 2 zu 2, 3 zu 1 und 4 zu 0. Überlegen Sie sich zuerst welche mathematische Funktion man dafür benötigt.
  7. Das Geschlecht ist mit Zahlen kodiert. Ändern Sie diese so ab, dass 0 zu weiblich, 1 zu maennlich und 2 zu divers wird. Tipp: Nutzen Sie die Funktion case_when().
  8. Machen Sie aus den ja/nein-Fragen, sowie dem Geschlecht und der Gruppe jeweils einen Faktor.
  9. Schreiben Sie nun alle Änderungen, die Sie im Laufe der Aufgabe gemacht haben (mit Ausname des Einlesens), zusammenfassend in eine Zuweisung, so dass alle Schritte in Einem gemacht werden! Bemerkung: So könnte dann ein fertiges Skript aussehen, das Rohdaten einliest und konvertiert!
  10. Nutzen sie zu guter Letzt die Funktion summary() um die Unterschiede des Datensatzes vom Anfang und zum Ende der Analyse zu sehen. Welchen Vorteil haben die Faktoren?

Lösung

  1. library(pacman)
    p_load(tidyverse)
    
    # Einlesen erzeugt den Code:
    umfrage2024 <- read_delim("umfrage2024.csv", 
                               delim = ";", 
                               escape_double = FALSE, 
                               trim_ws = TRUE)
    
    # wobei statt "umfrage2024.csv" da auch der Pfad zu der Datei stehen kann.

    Bemerkung: Bei den folgenden Aufgabenteilen stehen die runden Klammern um den Ausdruck, damit nicht nur eine Zuweisung erfolgt, sondern das entehende Objekt auch ausgegeben wird.

  2. (umfrage2 <- umfrage2024 |> 
                     rename(Frage10_gruppe = Frage10_GRUPPE,
                            Frage11_alter = Frage11_ALTER)
    )
    # A tibble: 50 × 11
       Frage01_log Frage02_log Frage03_log Frage04_num_invers Frage05_num_invers
       <lgl>       <lgl>       <lgl>                    <int>              <int>
     1 TRUE        FALSE       FALSE                        5                  3
     2 FALSE       TRUE        TRUE                         2                  4
     3 TRUE        FALSE       FALSE                        3                  2
     4 TRUE        TRUE        TRUE                         4                  5
     5 FALSE       TRUE        TRUE                         5                  1
     6 TRUE        TRUE        TRUE                         5                  4
     7 FALSE       FALSE       TRUE                         4                  2
     8 TRUE        FALSE       FALSE                        3                  5
     9 TRUE        FALSE       FALSE                        3                  2
    10 TRUE        FALSE       FALSE                        4                  2
    # ℹ 40 more rows
    # ℹ 6 more variables: Frage06_num <int>, Frage07_num <int>,
    #   Frage08_num_invers <int>, Frage09_geschlecht <dbl>, Frage10_gruppe <chr>,
    #   Frage11_alter <dbl>
  3. (umfrage3 <- umfrage2 |> 
                     drop_na() |> 
                     filter(between(Frage11_alter, 18, 30))
    )
    # A tibble: 44 × 11
       Frage01_log Frage02_log Frage03_log Frage04_num_invers Frage05_num_invers
       <lgl>       <lgl>       <lgl>                    <int>              <int>
     1 TRUE        FALSE       FALSE                        5                  3
     2 FALSE       TRUE        TRUE                         2                  4
     3 TRUE        FALSE       FALSE                        3                  2
     4 FALSE       TRUE        TRUE                         5                  1
     5 TRUE        TRUE        TRUE                         5                  4
     6 FALSE       FALSE       TRUE                         4                  2
     7 TRUE        FALSE       FALSE                        3                  5
     8 TRUE        FALSE       FALSE                        3                  2
     9 TRUE        FALSE       FALSE                        4                  2
    10 FALSE       FALSE       TRUE                         5                  5
    # ℹ 34 more rows
    # ℹ 6 more variables: Frage06_num <int>, Frage07_num <int>,
    #   Frage08_num_invers <int>, Frage09_geschlecht <dbl>, Frage10_gruppe <chr>,
    #   Frage11_alter <dbl>
  4. (umfrage4 <- umfrage3 |> mutate(across(ends_with("log"), 
                                          \(x) ifelse(x, "ja", "nein")))
    
    )
    # A tibble: 44 × 11
       Frage01_log Frage02_log Frage03_log Frage04_num_invers Frage05_num_invers
       <chr>       <chr>       <chr>                    <int>              <int>
     1 ja          nein        nein                         5                  3
     2 nein        ja          ja                           2                  4
     3 ja          nein        nein                         3                  2
     4 nein        ja          ja                           5                  1
     5 ja          ja          ja                           5                  4
     6 nein        nein        ja                           4                  2
     7 ja          nein        nein                         3                  5
     8 ja          nein        nein                         3                  2
     9 ja          nein        nein                         4                  2
    10 nein        nein        ja                           5                  5
    # ℹ 34 more rows
    # ℹ 6 more variables: Frage06_num <int>, Frage07_num <int>,
    #   Frage08_num_invers <int>, Frage09_geschlecht <dbl>, Frage10_gruppe <chr>,
    #   Frage11_alter <dbl>
  5. (umfrage5 <- umfrage4 |> mutate(across(contains("num"), 
                                          \(x) x-1))
    )
    # A tibble: 44 × 11
       Frage01_log Frage02_log Frage03_log Frage04_num_invers Frage05_num_invers
       <chr>       <chr>       <chr>                    <dbl>              <dbl>
     1 ja          nein        nein                         4                  2
     2 nein        ja          ja                           1                  3
     3 ja          nein        nein                         2                  1
     4 nein        ja          ja                           4                  0
     5 ja          ja          ja                           4                  3
     6 nein        nein        ja                           3                  1
     7 ja          nein        nein                         2                  4
     8 ja          nein        nein                         2                  1
     9 ja          nein        nein                         3                  1
    10 nein        nein        ja                           4                  4
    # ℹ 34 more rows
    # ℹ 6 more variables: Frage06_num <dbl>, Frage07_num <dbl>,
    #   Frage08_num_invers <dbl>, Frage09_geschlecht <dbl>, Frage10_gruppe <chr>,
    #   Frage11_alter <dbl>
  6. (umfrage6 <- umfrage5 |> mutate(across(ends_with("invers"), 
                                          \(x) 4-x))
    )
    # A tibble: 44 × 11
       Frage01_log Frage02_log Frage03_log Frage04_num_invers Frage05_num_invers
       <chr>       <chr>       <chr>                    <dbl>              <dbl>
     1 ja          nein        nein                         0                  2
     2 nein        ja          ja                           3                  1
     3 ja          nein        nein                         2                  3
     4 nein        ja          ja                           0                  4
     5 ja          ja          ja                           0                  1
     6 nein        nein        ja                           1                  3
     7 ja          nein        nein                         2                  0
     8 ja          nein        nein                         2                  3
     9 ja          nein        nein                         1                  3
    10 nein        nein        ja                           0                  0
    # ℹ 34 more rows
    # ℹ 6 more variables: Frage06_num <dbl>, Frage07_num <dbl>,
    #   Frage08_num_invers <dbl>, Frage09_geschlecht <dbl>, Frage10_gruppe <chr>,
    #   Frage11_alter <dbl>
  7. umfrage7 <- umfrage6 |> mutate(across(Frage09_geschlecht, 
                                          \(x) case_when(x == 0 ~ "weiblich",
                                                         x == 1 ~ "maennlich",
                                                         x == 2 ~ "divers")))
    
    # sinnvollen Teil ansehen:
    umfrage7 |> select(Frage09_geschlecht)
    # A tibble: 44 × 1
       Frage09_geschlecht
       <chr>             
     1 weiblich          
     2 weiblich          
     3 maennlich         
     4 weiblich          
     5 weiblich          
     6 maennlich         
     7 maennlich         
     8 divers            
     9 maennlich         
    10 maennlich         
    # ℹ 34 more rows
  8. umfrage8 <- umfrage7 |> mutate(across(c(ends_with("log"),
                                             Frage09_geschlecht, 
                                             Frage10_gruppe), factor))
  9. (umfrageEnde <- umfrage2024 |> 
                    drop_na() |> 
                    rename(Frage10_gruppe = Frage10_GRUPPE,
                           Frage11_alter = Frage11_ALTER) |>               
                    filter(between(Frage11_alter, 18, 30)) |> 
                    mutate(across(ends_with("log"),  \(x) {ifelse(x, "ja", "nein")}),
                           across(contains("num"), \(x) {x-1}),
                           across(ends_with("invers"),\(x) {4-x}), 
                           across(Frage09_geschlecht, 
                                          \(x) case_when(x == 0 ~ "weiblich",
                                                         x == 1 ~ "maennlich",
                                                         x == 2 ~ "divers")),
                           across(c(ends_with("log"), 
                                    Frage09_geschlecht, 
                                    Frage10_gruppe), factor)
                           )
    
    )
    # A tibble: 44 × 11
       Frage01_log Frage02_log Frage03_log Frage04_num_invers Frage05_num_invers
       <fct>       <fct>       <fct>                    <dbl>              <dbl>
     1 ja          nein        nein                         0                  2
     2 nein        ja          ja                           3                  1
     3 ja          nein        nein                         2                  3
     4 nein        ja          ja                           0                  4
     5 ja          ja          ja                           0                  1
     6 nein        nein        ja                           1                  3
     7 ja          nein        nein                         2                  0
     8 ja          nein        nein                         2                  3
     9 ja          nein        nein                         1                  3
    10 nein        nein        ja                           0                  0
    # ℹ 34 more rows
    # ℹ 6 more variables: Frage06_num <dbl>, Frage07_num <dbl>,
    #   Frage08_num_invers <dbl>, Frage09_geschlecht <fct>, Frage10_gruppe <fct>,
    #   Frage11_alter <dbl>
  10. summary(umfrage2024)
     Frage01_log     Frage02_log     Frage03_log     Frage04_num_invers
     Mode :logical   Mode :logical   Mode :logical   Min.   :1.00      
     FALSE:23        FALSE:29        FALSE:21        1st Qu.:3.00      
     TRUE :26        TRUE :19        TRUE :29        Median :4.00      
     NAs  :1         NAs  :2                         Mean   :3.58      
                                                     3rd Qu.:5.00      
                                                     Max.   :5.00      
     Frage05_num_invers  Frage06_num    Frage07_num   Frage08_num_invers
     Min.   :1.00       Min.   :1.00   Min.   :1.00   Min.   :2.00      
     1st Qu.:2.00       1st Qu.:1.25   1st Qu.:1.00   1st Qu.:3.00      
     Median :3.50       Median :2.50   Median :2.00   Median :4.00      
     Mean   :3.44       Mean   :2.52   Mean   :2.62   Mean   :3.70      
     3rd Qu.:5.00       3rd Qu.:3.00   3rd Qu.:4.00   3rd Qu.:4.75      
     Max.   :5.00       Max.   :5.00   Max.   :5.00   Max.   :5.00      
     Frage09_geschlecht   Frage10_GRUPPE Frage11_ALTER 
     Min.   :0.00       Length   :50     Min.   :14.0  
     1st Qu.:0.00       N.unique : 2     1st Qu.:20.0  
     Median :1.00       N.blank  : 0     Median :22.0  
     Mean   :0.56       Min.nchar: 1     Mean   :24.3  
     3rd Qu.:1.00       Max.nchar: 1     3rd Qu.:25.0  
     Max.   :2.00                        Max.   :83.0  
    summary(umfrageEnde)
     Frage01_log Frage02_log Frage03_log Frage04_num_invers Frage05_num_invers
     ja  :21     ja  :16     ja  :25     Min.   :0.000      Min.   :0.000     
     nein:23     nein:28     nein:19     1st Qu.:0.000      1st Qu.:0.000     
                                         Median :1.000      Median :1.500     
                                         Mean   :1.409      Mean   :1.568     
                                         3rd Qu.:2.250      3rd Qu.:3.000     
                                         Max.   :4.000      Max.   :4.000     
      Frage06_num     Frage07_num    Frage08_num_invers Frage09_geschlecht
     Min.   :0.000   Min.   :0.000   Min.   :0.000      divers   : 1      
     1st Qu.:0.000   1st Qu.:0.000   1st Qu.:0.750      maennlich:23      
     Median :1.500   Median :1.000   Median :1.000      weiblich :20      
     Mean   :1.477   Mean   :1.659   Mean   :1.295                        
     3rd Qu.:2.000   3rd Qu.:3.000   3rd Qu.:2.000                        
     Max.   :4.000   Max.   :4.000   Max.   :3.000                        
     Frage10_gruppe Frage11_alter  
     A:22           Min.   :19.00  
     B:22           1st Qu.:20.00  
                    Median :22.00  
                    Mean   :22.48  
                    3rd Qu.:24.25  
                    Max.   :28.00  

Aufgabe 4.4: Klausuraufgabe (WS 2023/24 - Papier & Stift!)

  1. Erläutern Sie in wenigen Sätzen den konzeptionellen Aufbau einer ggplot-Grafik. Ihre Erklärung könnte die Stichworte Daten(tabelle), Merkmale, Beobachtungen, +, Mapping / Aesthetics, geometrische Funktion, Schichten / Layer enthalten.
  2. Es wurden sechs Grafiken mit ggplot erstellt wurden. Geben Sie für die dargestellten Merkmale sinnvolle Skalenniveaus an, sowie die verwendeten geometrischen Funktionen. Nicht jede Graphik zeigt drei Merkmale! Markieren Sie, wenn ein Merkmal nicht benötigt wird (z.B. durch ein X in der jeweiligen Zelle).
  3. Welches Paket kann man nutzen um die Grafiken in einem Dokument derart anzuordnen wie sie es in der Grafik sehen?
  4. Wie lautet die konkrete Syntax zu dieser Anordnung, wenn die Grafiken die Objekte g1, g2, g3, g4, g5 und g6 sind?

Nr. Merkmal 1 Merkmal 2 Merkmal 3 Geometrische Funktion(en)
(1)
(2)
(3)
(4)
(5)
(6)

Lösung

  • Grundlage für Graphiken in `ggplot2 sind Data Frames bzw.~Tibbles. Merkmale sind separiert in Spalten, eine Beobachtung ist eine Zeile.
  • Graphiken, die mit ggplot2 erstellt werden sind in Layern aufgebaut.
  • Das Grundgerüst ist ein ggplot()-Aufruf, alle weiteren Befehle werden mit + verbunden. Hier bzw.~in den geometrischen Funktionen, wir den Achsen, Farben, Formen, etc. ein Merkmal mit Hilfe der Funktion aes() (Aesthetics) zugeordnet.
  • Geometrische Funktionen stellen die eigentliche Graphik dar.
  • Das Finetuning (Achsen beschriften, Legende, Themenwahl (Farbe, Hintergrund,etc.) wird schichtweise mit weiteren Funktionen hinzugefügt.
Nr. Merkmal 1 Merkmal 2 Merkmal 3 Geometrische Funktion(en)
(1) nominal X X geom_bar()
(2) metrisch metrisch X geom_point()
(3) metrisch metrisch nominal geom_point(), facet_grid()
(4) metrisch nominal X geom_violin()
(5) nominal nominal X geom_mosaic()
(6) metrisch metrisch nominal geom_line()
  1. Ein Paket mit dem das möglich ist heißt patchwork.
  2. die konkrete Syntax wäre (nachdem man das Paket geladen hat): (g1|g2)/(g3|g4)/(g5|g6).

Aufgabe 4.5: KI Aufgabe

Für diese Aufgabe sollen Sie die KI nutzen! Bitte achten Sie aber darauf, dass Sie Funktionen aus dem Tidyverse nutzen! Versuchen Sie zu verstehen was passiert.

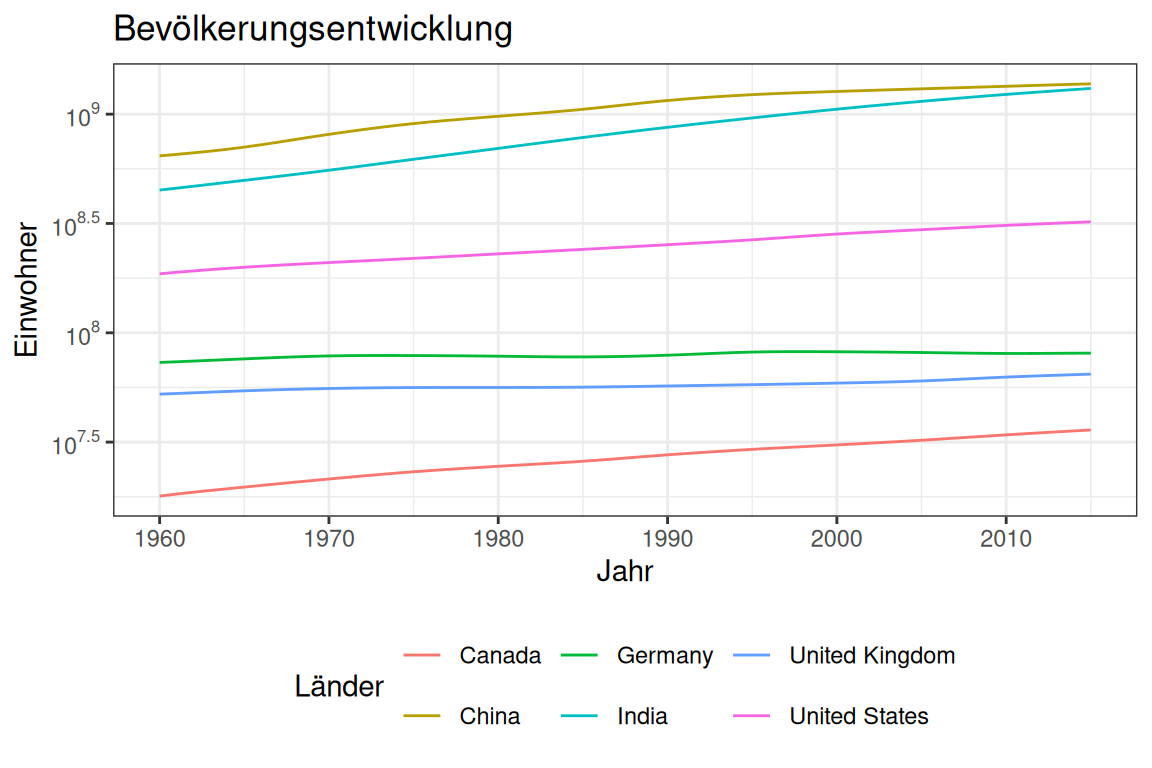
Für diese Aufgabe benötigen Sie neben tidyverse die Pakete dslabs, ggrepel und scales. Ziel der Aufgabe ist es Graphiken zu erstellen und die Darstellung (Farbgebung, Achsenbeschriftungen, Legende, Logarithmische Skala, etc.) anzupassen.

  1. Betrachten sie die Datentabelle gapminder aus dem Paket dslabs. Wandeln Sie die Tabelle in einen Tibble um und verschaffen sie sich eine kurze Übersicht über den Datensatz.

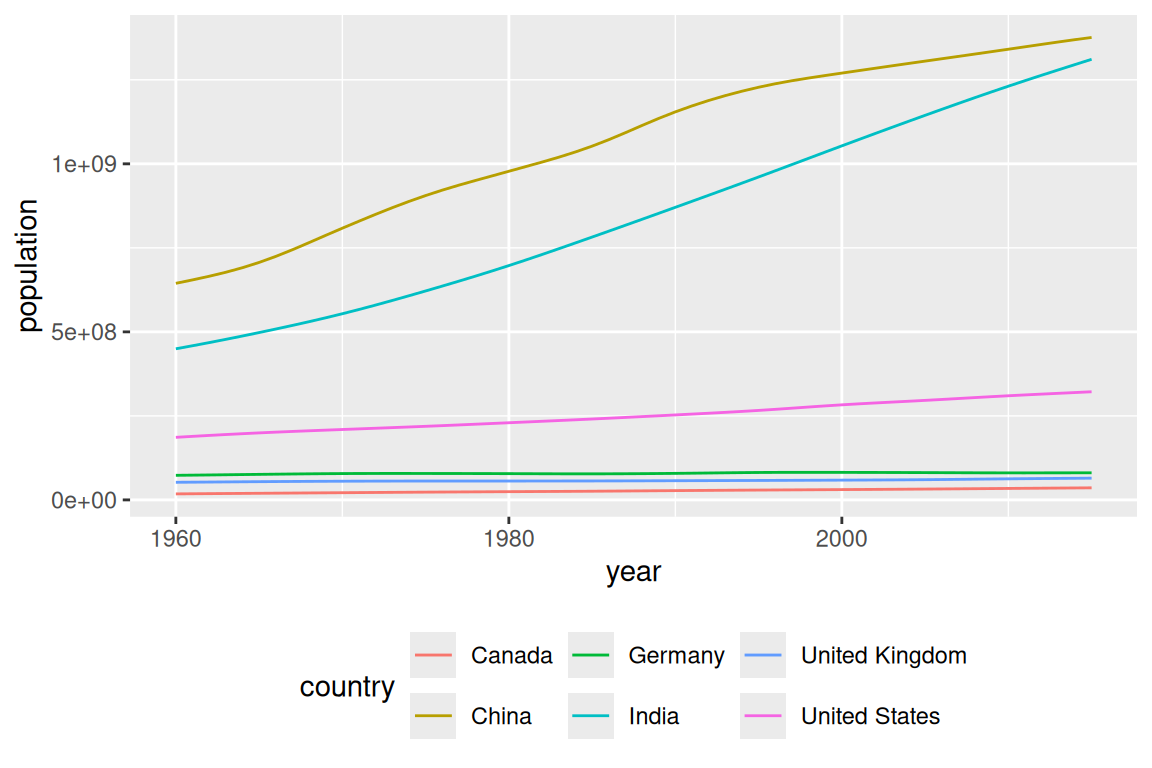
  2. Erstellen Sie ein Liniendiagramm in der Sie die Entwicklung der Bevölkerung der Länder: China, Indien, Deutschland, Vereinigte Staaten, Kanada und Großbritannien im Zeitraum von 1960 bis 2015 darstellen. Was fällt auf? Tipp: Nutzen Sie beim Filtern den Operator %in%.

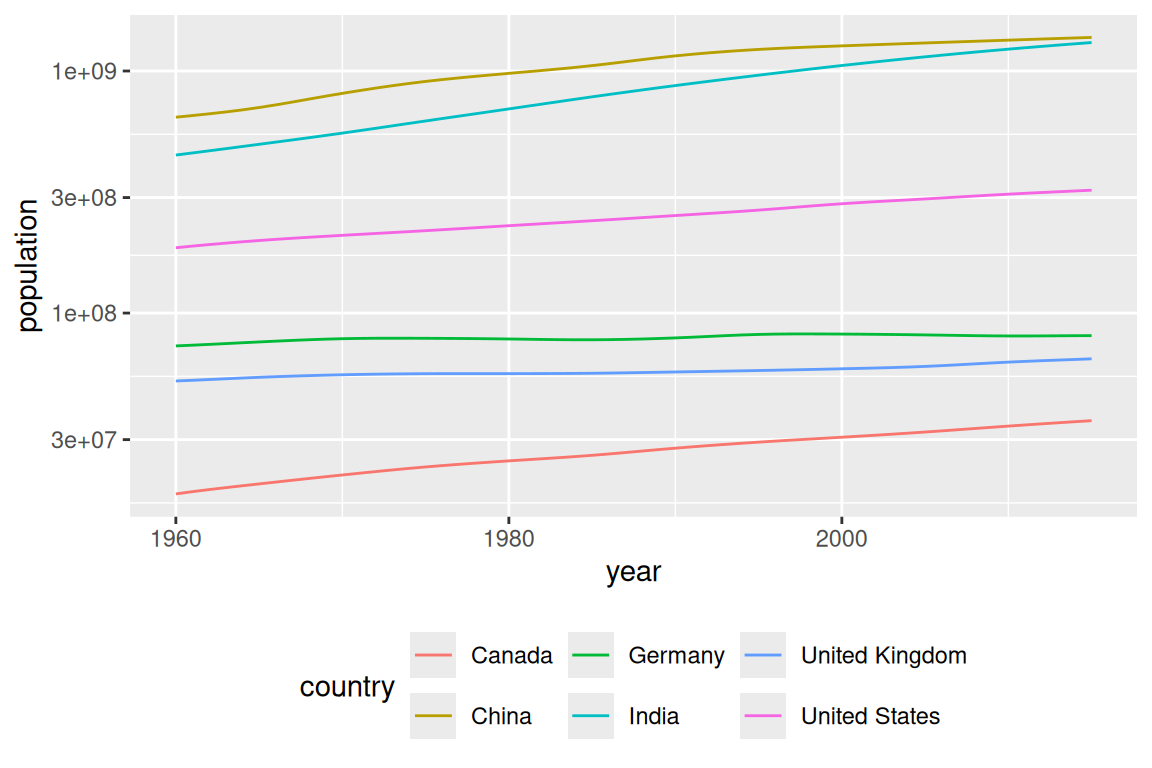
  3. Ändern sie die Graphik aus dem vorherigen Aufgabenteil derart ab, dass Sie die relative Entwicklung der Bevölkerung ablesen können (logarithmische Skala). Kann man nun allein anhand der Graphik sagen welche Länder den relativ größten Zuwachs hatten?

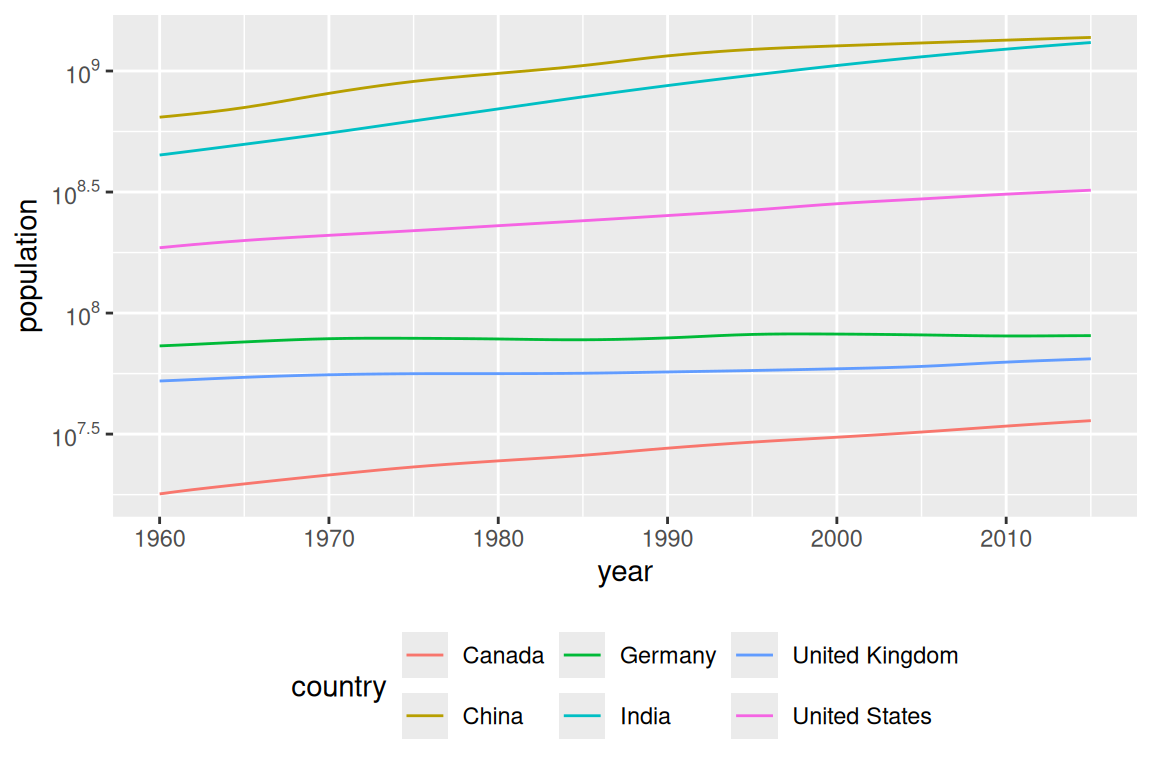
  4. Beschriften sie die Achsen derart, dass die \(x\)-Achse alle 10 Jahre zeigt, und die \(y\)-Achse eine schöne wissenschaftliche Darstellung (zum Beispiel \(10^{8}\) statt \(10e8\)) hat.

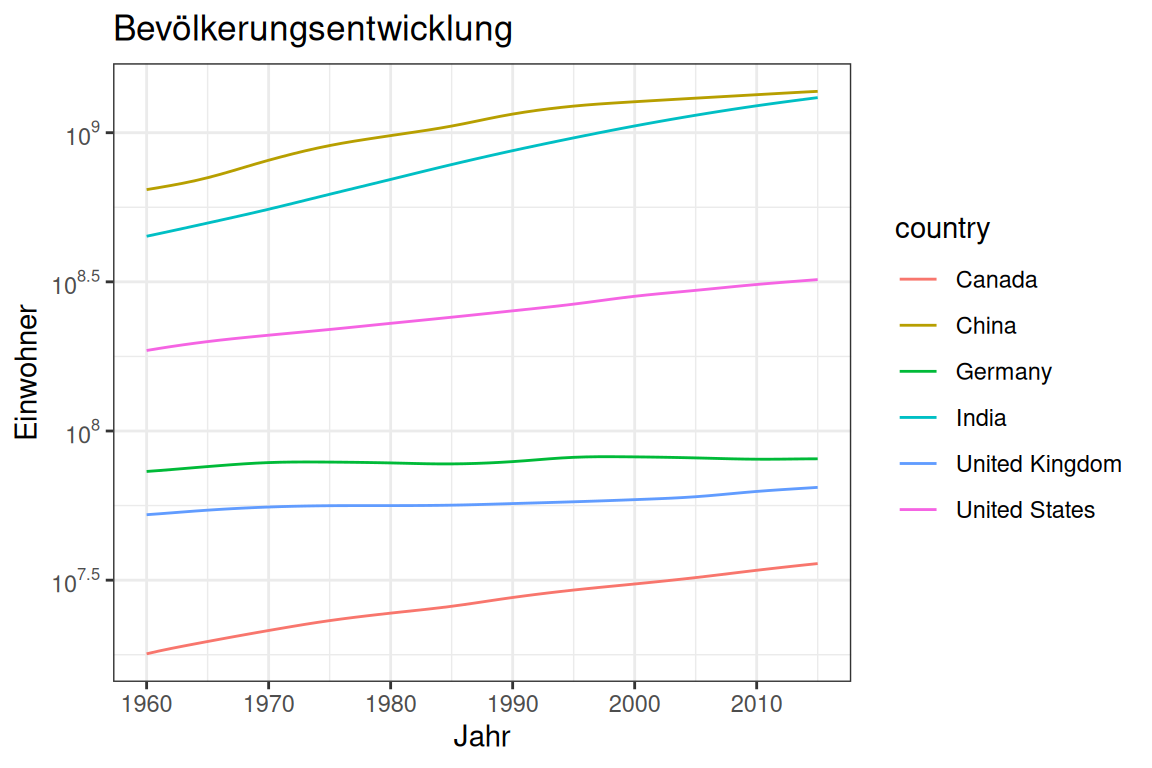
  5. Ändern Sie nun die Achsen- und Legendenbeschriftung, so dass diese entweder übersetzt oder zumindest kapitalisiert sind, und geben Sie der Graphik eine Überschrift.

  6. Ändern Sie mit Hilfe der Funktionen theme_*() den Hintergrund der Graphik.

  7. Die Standardeinstellung ist, dass die Legende rechts neben der Graphik eingeblendet ist. Versetzen sie diese so, dass sie unterhalb der Graphik erscheint.

Lösung

library(pacman)
p_load(tidyverse, dslabs, ggrepel)

# i)
gapminder <- gapminder |> as_tibble()

# ii)
mycountries <- c("China", "India", "Germany", "Canada", "United Kingdom", "United States")

gapminder |> filter(country %in% mycountries,
                    between(year, 1960, 2015)) |> 
             ggplot(aes(x = year, y = population)) + 
                geom_line(aes(color = country)) 

# Problem: China und Indien ein bis zwei Größenordnungen (Zehnerpotenzen) größer als andere  

# iii)

gapminder |> filter(country %in% mycountries,
                    between(year, 1960, 2015)) |> 
             ggplot(aes(x = year, y = population)) + 
                geom_line(aes(color = country)) +
                scale_y_continuous(trans = 'log10')

# Log-Skala besser, da relativer Zuwachs sichtbar: 
# Indien, China, Canada, USA, GB, Deutschland

# Rechnung (nicht gefragt in der Aufgabe):

 gapminder |> select(country, year, population) |> 
              filter(between(year, 1960, 2015)) |>
              filter(country %in% mycountries) |>  # auskommentieren ist interessant!
              pivot_wider(names_from = year, 
                          values_from = population) |> 
              transmute(country, popratio = `2015`/`1960`) |> 
              arrange(desc(popratio))
# A tibble: 6 × 2
  country        popratio
  <fct>             <dbl>
1 India              2.92
2 China              2.14
3 Canada             2.01
4 United States      1.73
5 United Kingdom     1.23
6 Germany            1.10
# iv)

# Eine kurze Recherche liefert, dass es gut ist das Paket scales zu nutzen:
p_load(scales)
 
gapminder |> filter(country %in% mycountries,
                    between(year, 1960, 2015)) |> 
             ggplot(aes(x = year, y = population)) + 
                geom_line(aes(color = country)) +
                scale_y_continuous(trans = log10_trans(),
                            breaks = trans_breaks("log10", function(x) 10^x),
                            labels = trans_format("log10", math_format(10^.x))) +
                scale_x_continuous(breaks = seq(1960,2010,10))

# v) + vi)
 
gapminder |> filter(country %in% mycountries,
                    between(year, 1960, 2015)) |> 
             ggplot(aes(x = year, y = population)) + 
                geom_line(aes(color = country)) +
                scale_y_continuous(trans = log10_trans(),
                            breaks = trans_breaks("log10", function(x) 10^x),
                            labels = trans_format("log10", math_format(10^.x))) +
                scale_x_continuous(breaks = seq(1960,2010,10)) + 
                labs(x = "Jahr", y = "Einwohner", title = "Bevölkerungsentwicklung") + 
                theme_bw()

# vii)

gapminder |> filter(country %in% mycountries,
                    between(year, 1960, 2015)) |> 
             ggplot(aes(x = year, y = population)) + 
                geom_line(aes(color = country)) +
                scale_y_continuous(trans = log10_trans(),
                            breaks = trans_breaks("log10", function(x) 10^x),
                            labels = trans_format("log10", math_format(10^.x))) +
                scale_x_continuous(breaks = seq(1960,2010,10)) + 
                labs(x = "Jahr", 
                     y = "Einwohner", 
                     title = "Bevölkerungsentwicklung",
                     color = "Länder") +  
                theme_bw() +
                theme(legend.position="bottom")

Bemerkung: Im letzten Schritt würden alle Labels, inklusiv der der Legende geändert. Die Syntax labs(color = "Länder")) überrascht vielleicht. Die Idee hier ist, color das Argument ist mit dem die Farben vergeben wurden und daher auch darüber die Legende einen Namen bekommt. Analoges geht für fill, size und so weiter.