Übung vom 03.11.2026

Vektoren erstellen

1:10
 [1]  1  2  3  4  5  6  7  8  9 10
seq(1,10, by = 0.5)
 [1]  1.0  1.5  2.0  2.5  3.0  3.5  4.0  4.5  5.0  5.5  6.0  6.5  7.0  7.5  8.0
[16]  8.5  9.0  9.5 10.0
seq(1,100, length.out = 42)
 [1]   1.000000   3.414634   5.829268   8.243902  10.658537  13.073171
 [7]  15.487805  17.902439  20.317073  22.731707  25.146341  27.560976
[13]  29.975610  32.390244  34.804878  37.219512  39.634146  42.048780
[19]  44.463415  46.878049  49.292683  51.707317  54.121951  56.536585
[25]  58.951220  61.365854  63.780488  66.195122  68.609756  71.024390
[31]  73.439024  75.853659  78.268293  80.682927  83.097561  85.512195
[37]  87.926829  90.341463  92.756098  95.170732  97.585366 100.000000
rep(c(1,10), 10)
 [1]  1 10  1 10  1 10  1 10  1 10  1 10  1 10  1 10  1 10  1 10
rep(c(1,10), each = 10)
 [1]  1  1  1  1  1  1  1  1  1  1 10 10 10 10 10 10 10 10 10 10
rep(c(1,10), c(3,10)) 
 [1]  1  1  1 10 10 10 10 10 10 10 10 10 10
Mit ?seq kann man die Hilfe ansehen: in dieser stehen die Argumente der Funktion erklärt. Die Beispiele am Ende der Hilfe helfen oft die Funktionen und ihre Argumente zu verstehen.

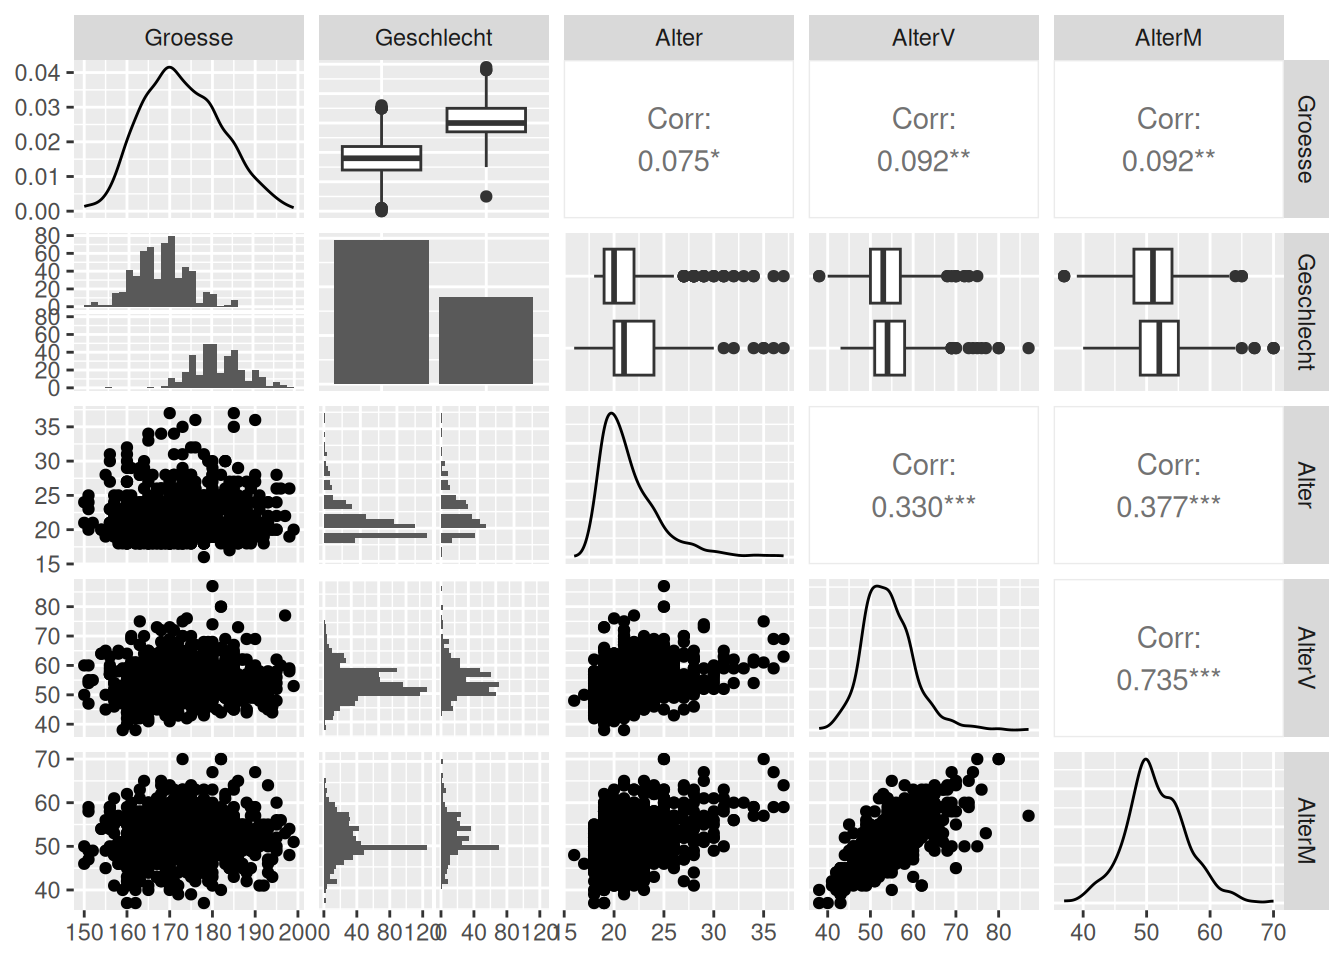
library(pacman)
p_load(tidyverse, GGally, DA.students)


dat.studenten |> drop_na()  |>  
                   # entfernt alle Zeilen in denen NAs stehen
                 select(Groesse, Geschlecht, starts_with("Alter")) |>  
                   # Auswahl der Merkmal
                 ggpairs()
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.

Einlesen von Daten

Eine kurze (und vorerst ausreichende) Einführung ist im Kapitel 3.4 Einlesen von Datentabellen ausführliche Anleitung finden Sie im Kapitel 16 Datenimport

Das Einlesen einer csv-Datei kann über das RStudio Menu Import Dataset >> From Text (readr) erfolgen. Der Code zum Einlesen kann dann in ein Skript kopiert werden und ist dann von der folgenden Form:

library(pacman)
p_load(tidyverse)

umfrage2024 <- read_delim("mitschriften/umfrage2024.csv",  # Pfad + Datei
                          delim = ";",                     # Spalten-/Merkmalstrenner 
                          escape_double = FALSE,           # Für einige Sonderzeichen
                          trim_ws = TRUE)                  # führende Leerzeichen werden entfernt

Alternativ gibt es die Funktionen

  • read_csv() : Spaltentrenner ist Komma , und Dezimaltrenner ist . - üblich für englischsprachige Tabellen.
  • read_csv2() : Spaltentrenner ist ; und Dezimaltrenner ist , - bei deutschen Datentabellen üblich.